图增强RAG知识平台
从底层重新设计的企业级 RAG 平台,专攻向量检索解决不了的两件事:复杂表格抽取,以及跨数千页技术文档的多跳推理。项目从汽车售后场景孵化,目前已在汽车、医药、媒体三大垂直行业的企业客户生产环境中运行。 系统由三大支柱协同构成:LLM 驱动的 Agentic Indexing 让系统像人一样读懂文档;知识图谱检索层能在跨长手册的实体间进行多跳推理;边界框溯源系统让每一个答案都能一键跳转到原文精确段落进行验证。
完整用户链路演示——从知识注入、知识库查看,到提问、LLM回答,再到边界框级溯源引用
项目背景
从汽车行业孵化,随后在医药和媒体娱乐行业完成产品化复制——目前已在三大垂直行业的11个企业客户生产环境运行。
4个经典汽车行业场景
在数千页技术文档上进行故障模式与影响分析
面向现场技术人员的维修手册步骤检索
售后服务团队的快速知识上手与传递
从产品知识库中提供有引用来源的精准回答
生产环境效果:纯向量 vs. 图增强
在第一个生产环境落地场景——某商用车 OEM 的汽车售后——维修知识分散在成千上万份手册和工单中,且跨多种语言。纯向量 RAG 的基线准确率停在 75% 左右,而在这个场景里,答错一次就意味着修错一次。把知识层重构为基于 Neptune、OpenSearch 和 Bedrock 的图增强 RAG 之后,问答准确率提升至 90% 以上——系统能够推理零件、故障码与维修步骤之间的真实关联,而不只是找语义上看起来相似的内容。
该数据测量自生产环境部署。下文的 95%+ 是另一个口径:客户在选型阶段主导出题的 100 题竞标评测。
平台的三大支柱
每一根支柱都精准对应向量 RAG 单独无法解决的一个核心痛点。
LLM 驱动解析——保留表格结构、自动生成图片描述、按语义单元分块。
知识图谱支撑跨长手册、跨实体的多跳推理。
边界框级精度——一键验证到原文精确页的精确段落。
技术方案
Agentic Indexing
实体与关系的抽取由可配置的 LLM prompt 模板驱动——运营团队可以按文档类型(汽车服务手册、医药法规申报、嵌入式数据手册)各自调整抽取规则,完全不用改代码。这正是同一套平台能在三个垂直行业通用的关键。
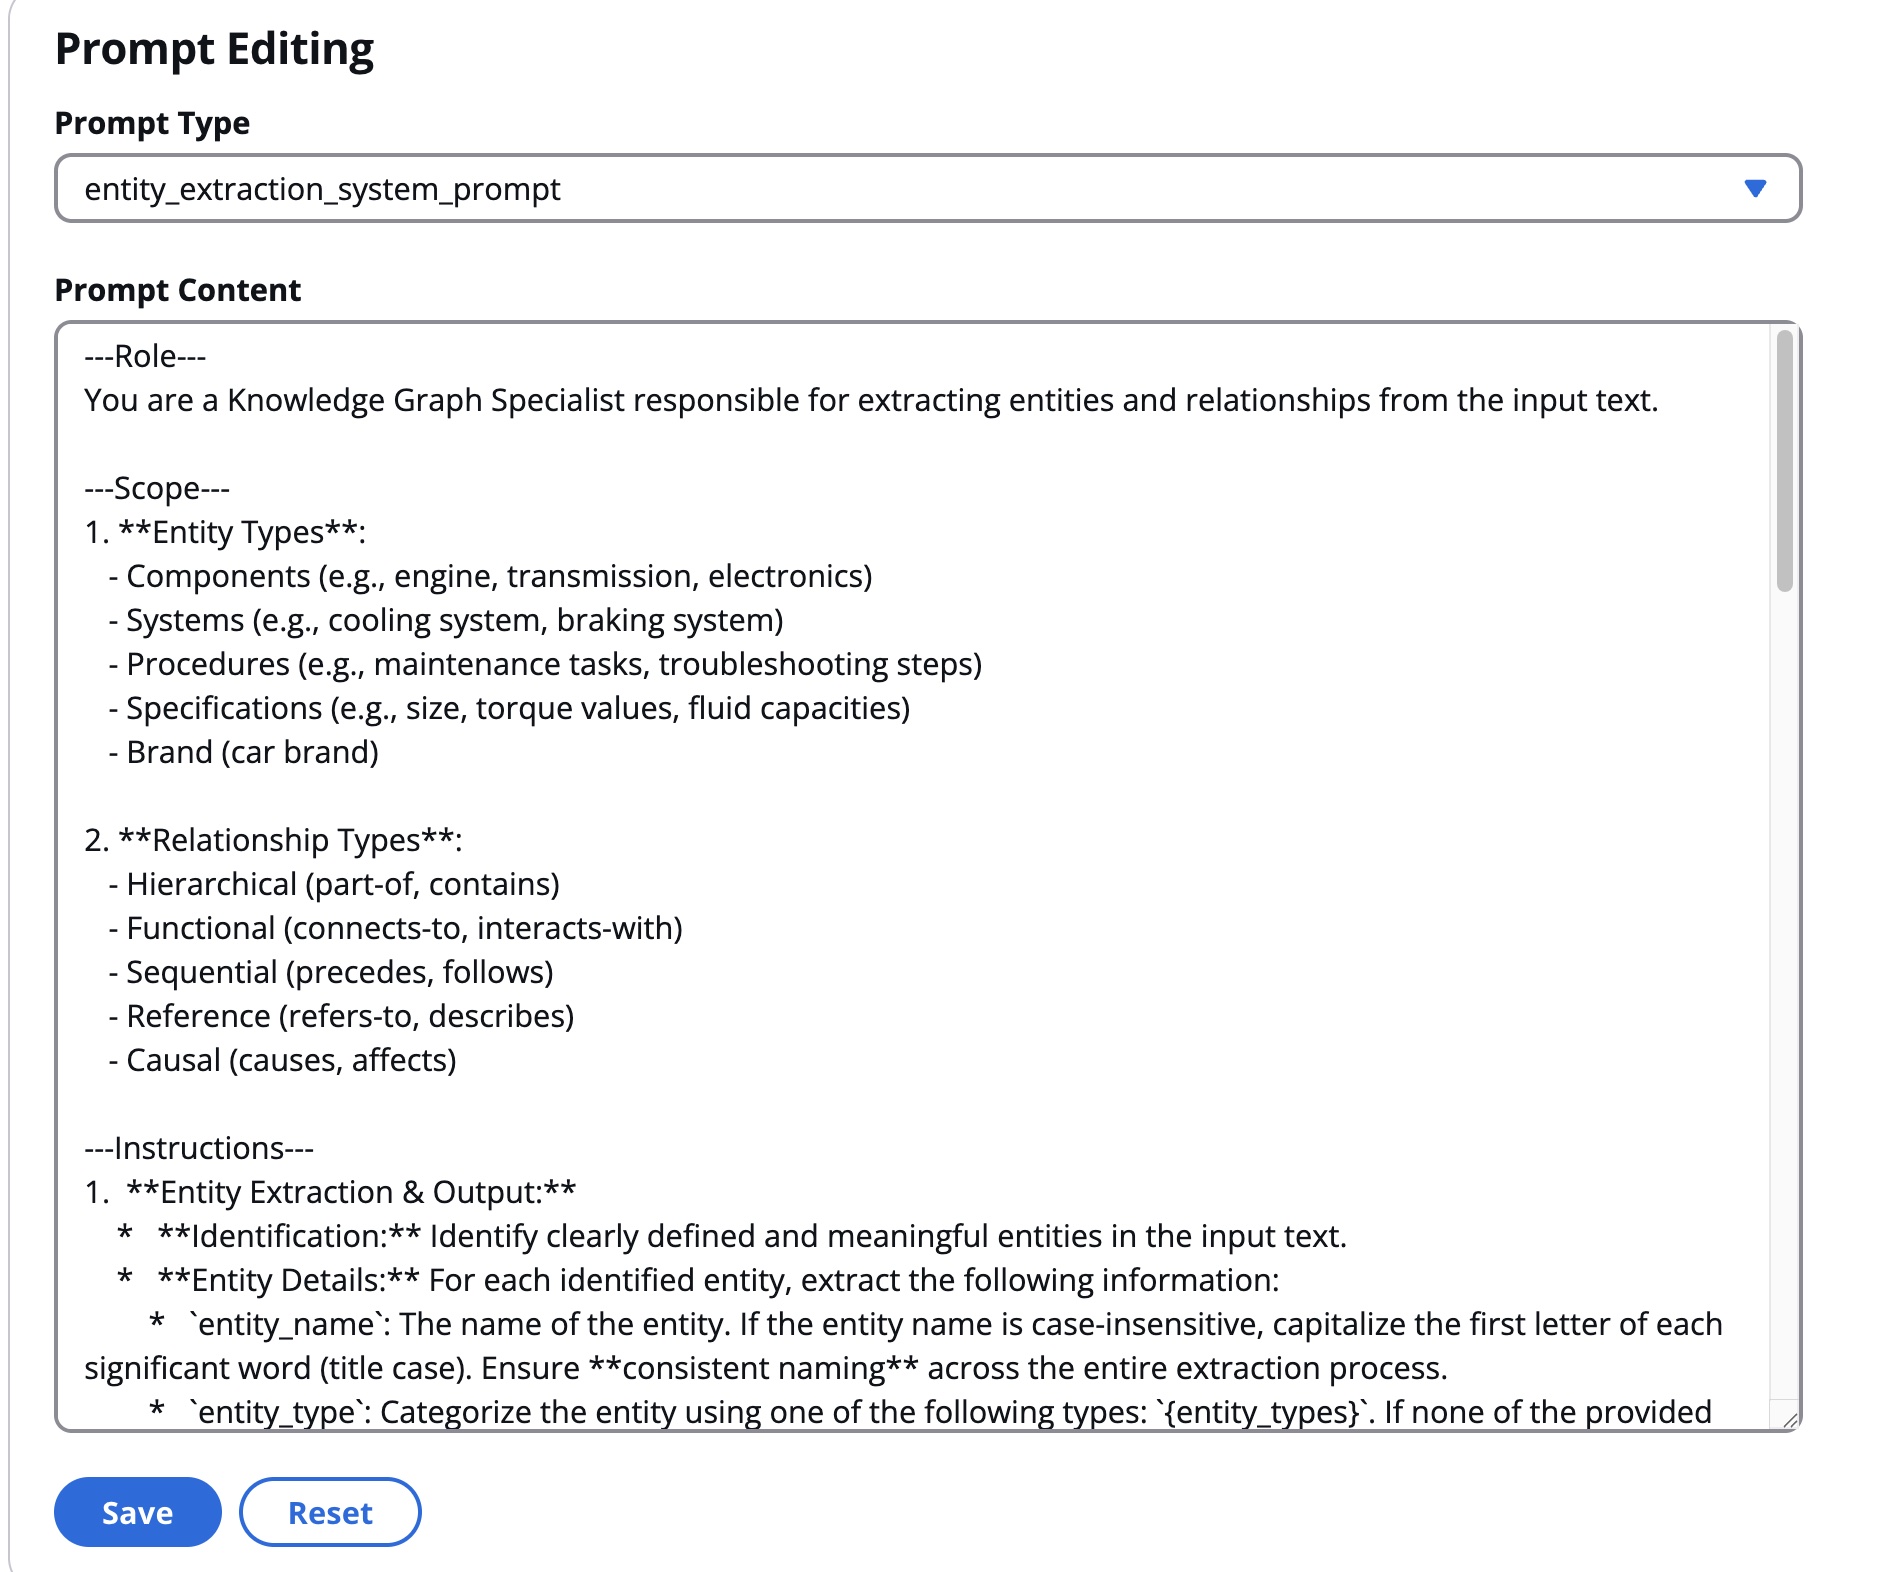
Prompt 编辑器界面——驱动 Agentic Indexing 的实体与关系抽取模板
基于知识图谱的多跳推理
系统从知识图谱中检索相关实体和关系,作为额外的检索上下文——支持跨多个文档的推理链。从根本上解决了传统向量RAG无法实现的能力。
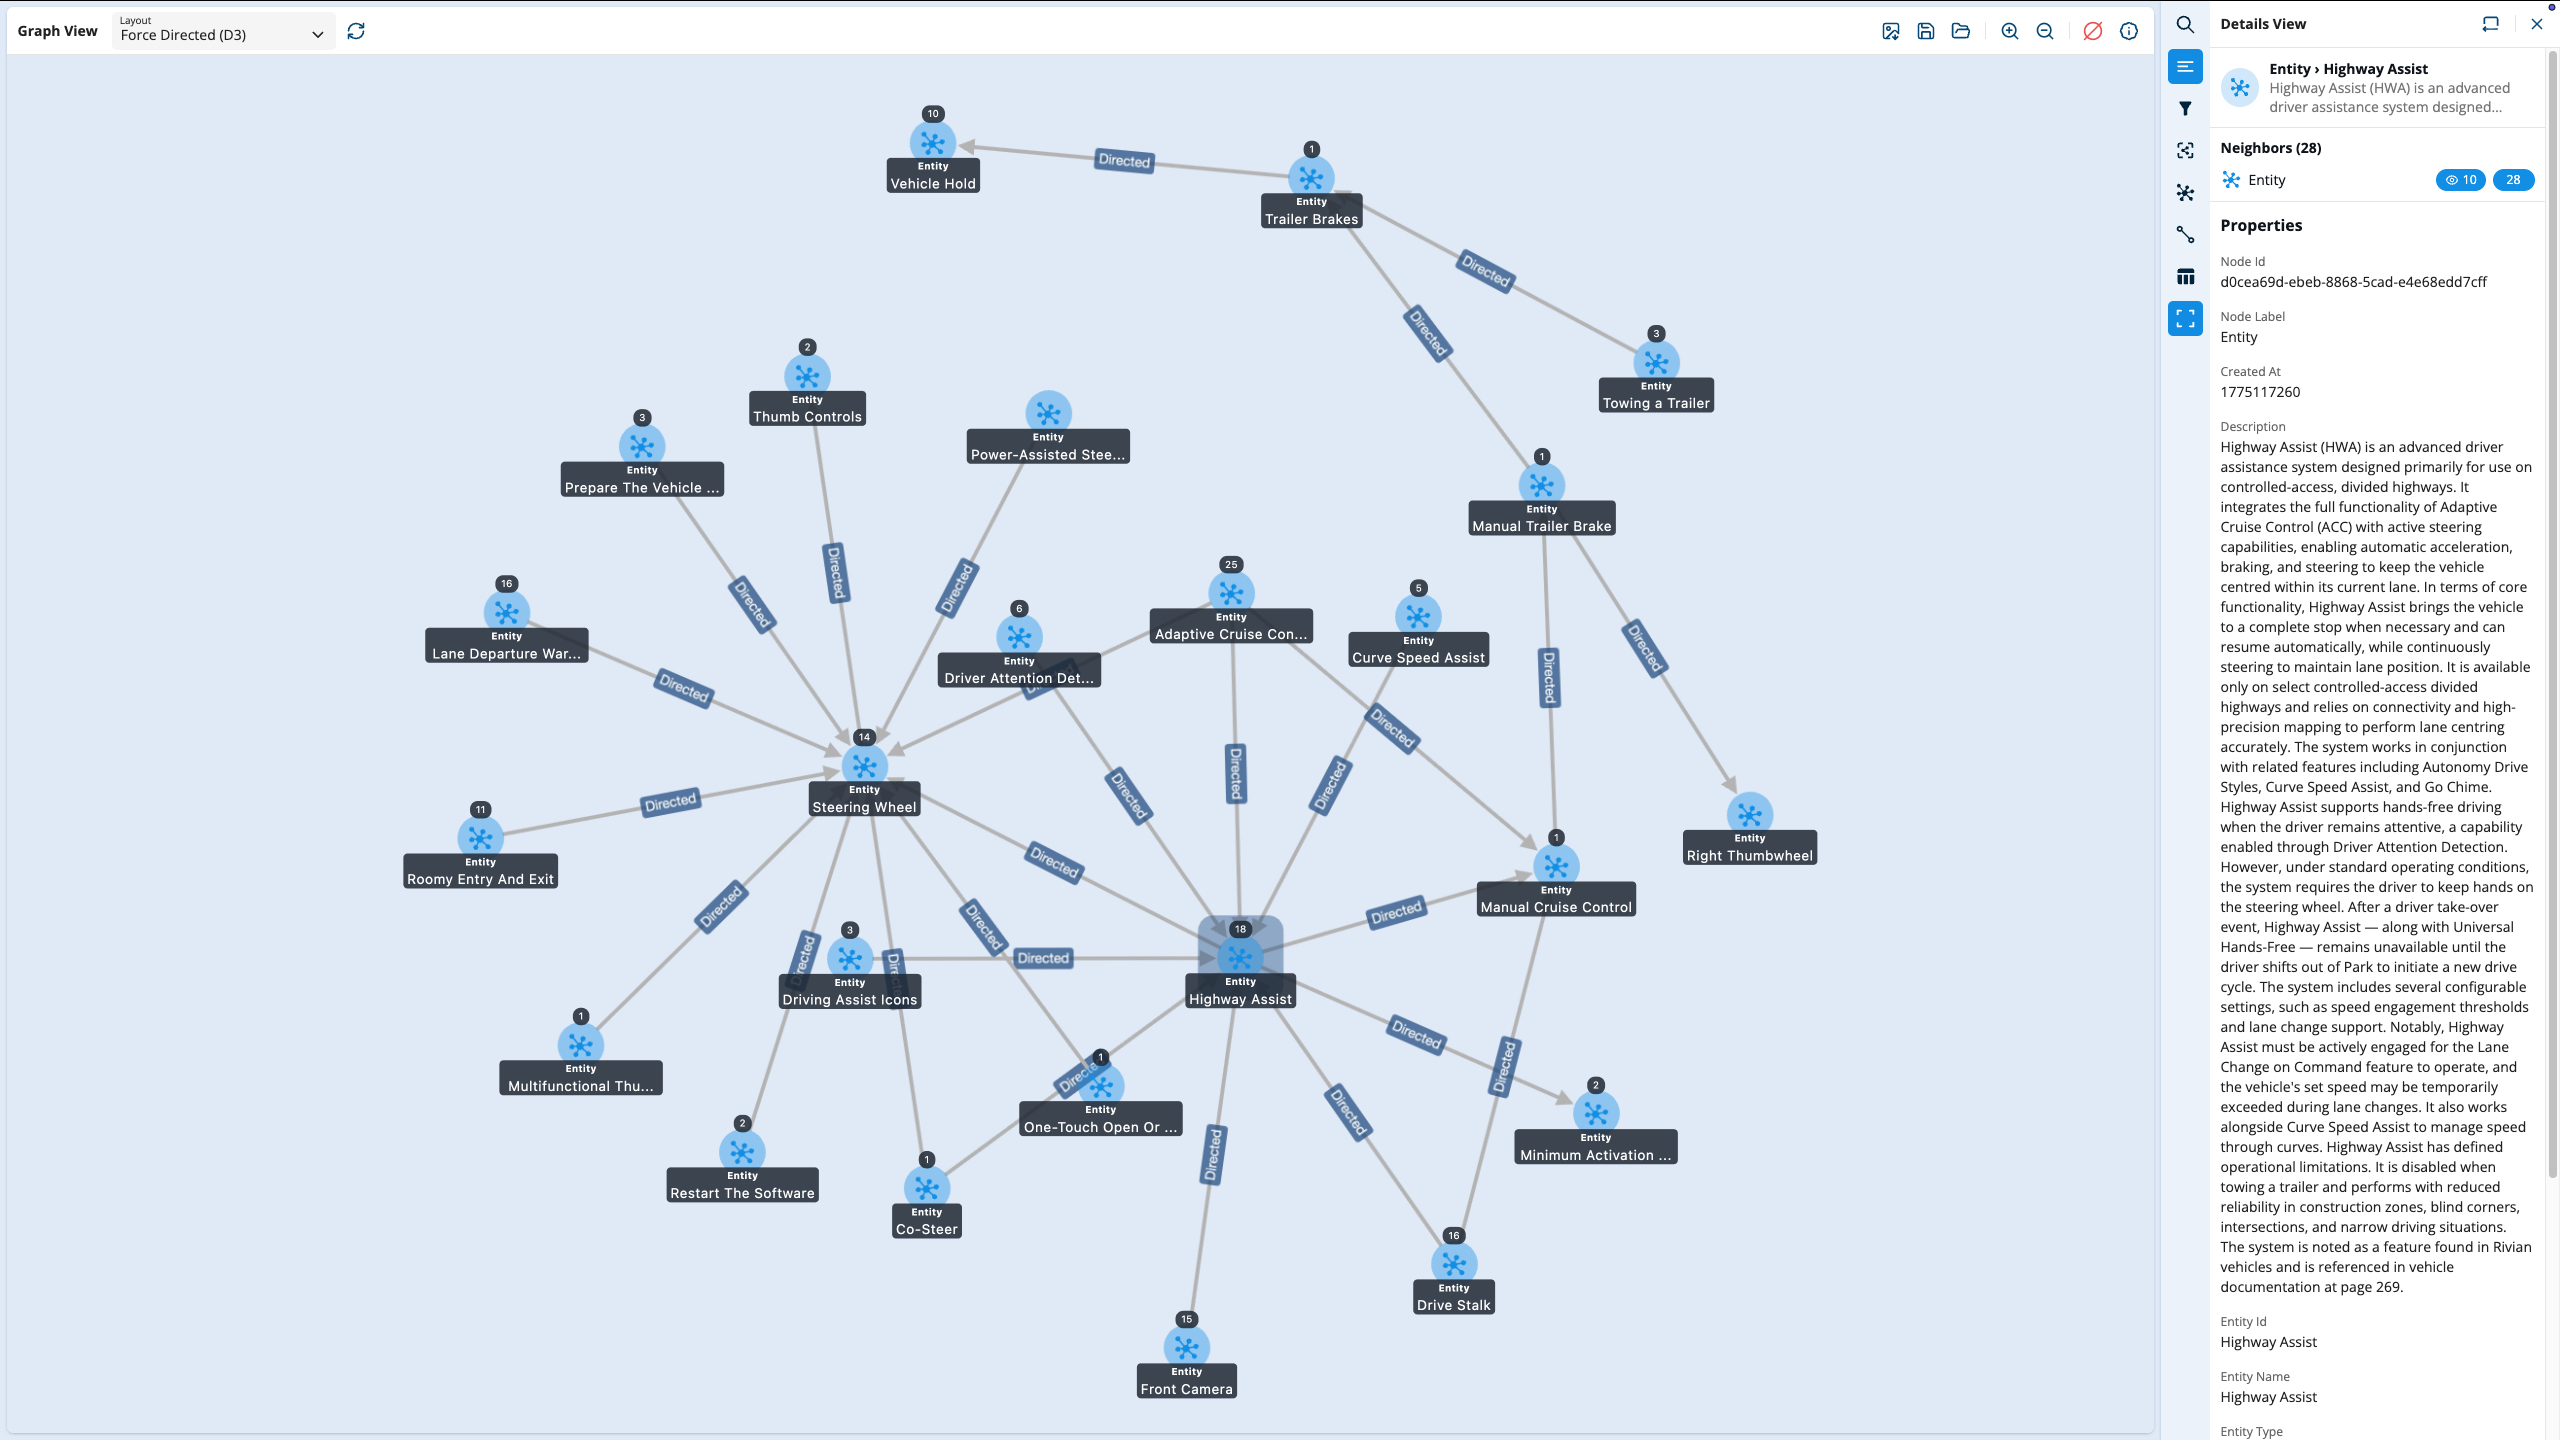
Neptune 中的知识图谱底层存储——实体顶点与关系边,查询时被遍历以实现多跳推理
PDF Object Level 精准溯源
端到端边界框级别来源溯源流水线——从文档解析、分块索引到跨页前端渲染——实现行级引用精度。成为对抗 Azure GraphRAG、阿里云、开源 RAGFlow 及研究团队方案的每次竞争性投标中推动客户转化的决定性差异化因素。
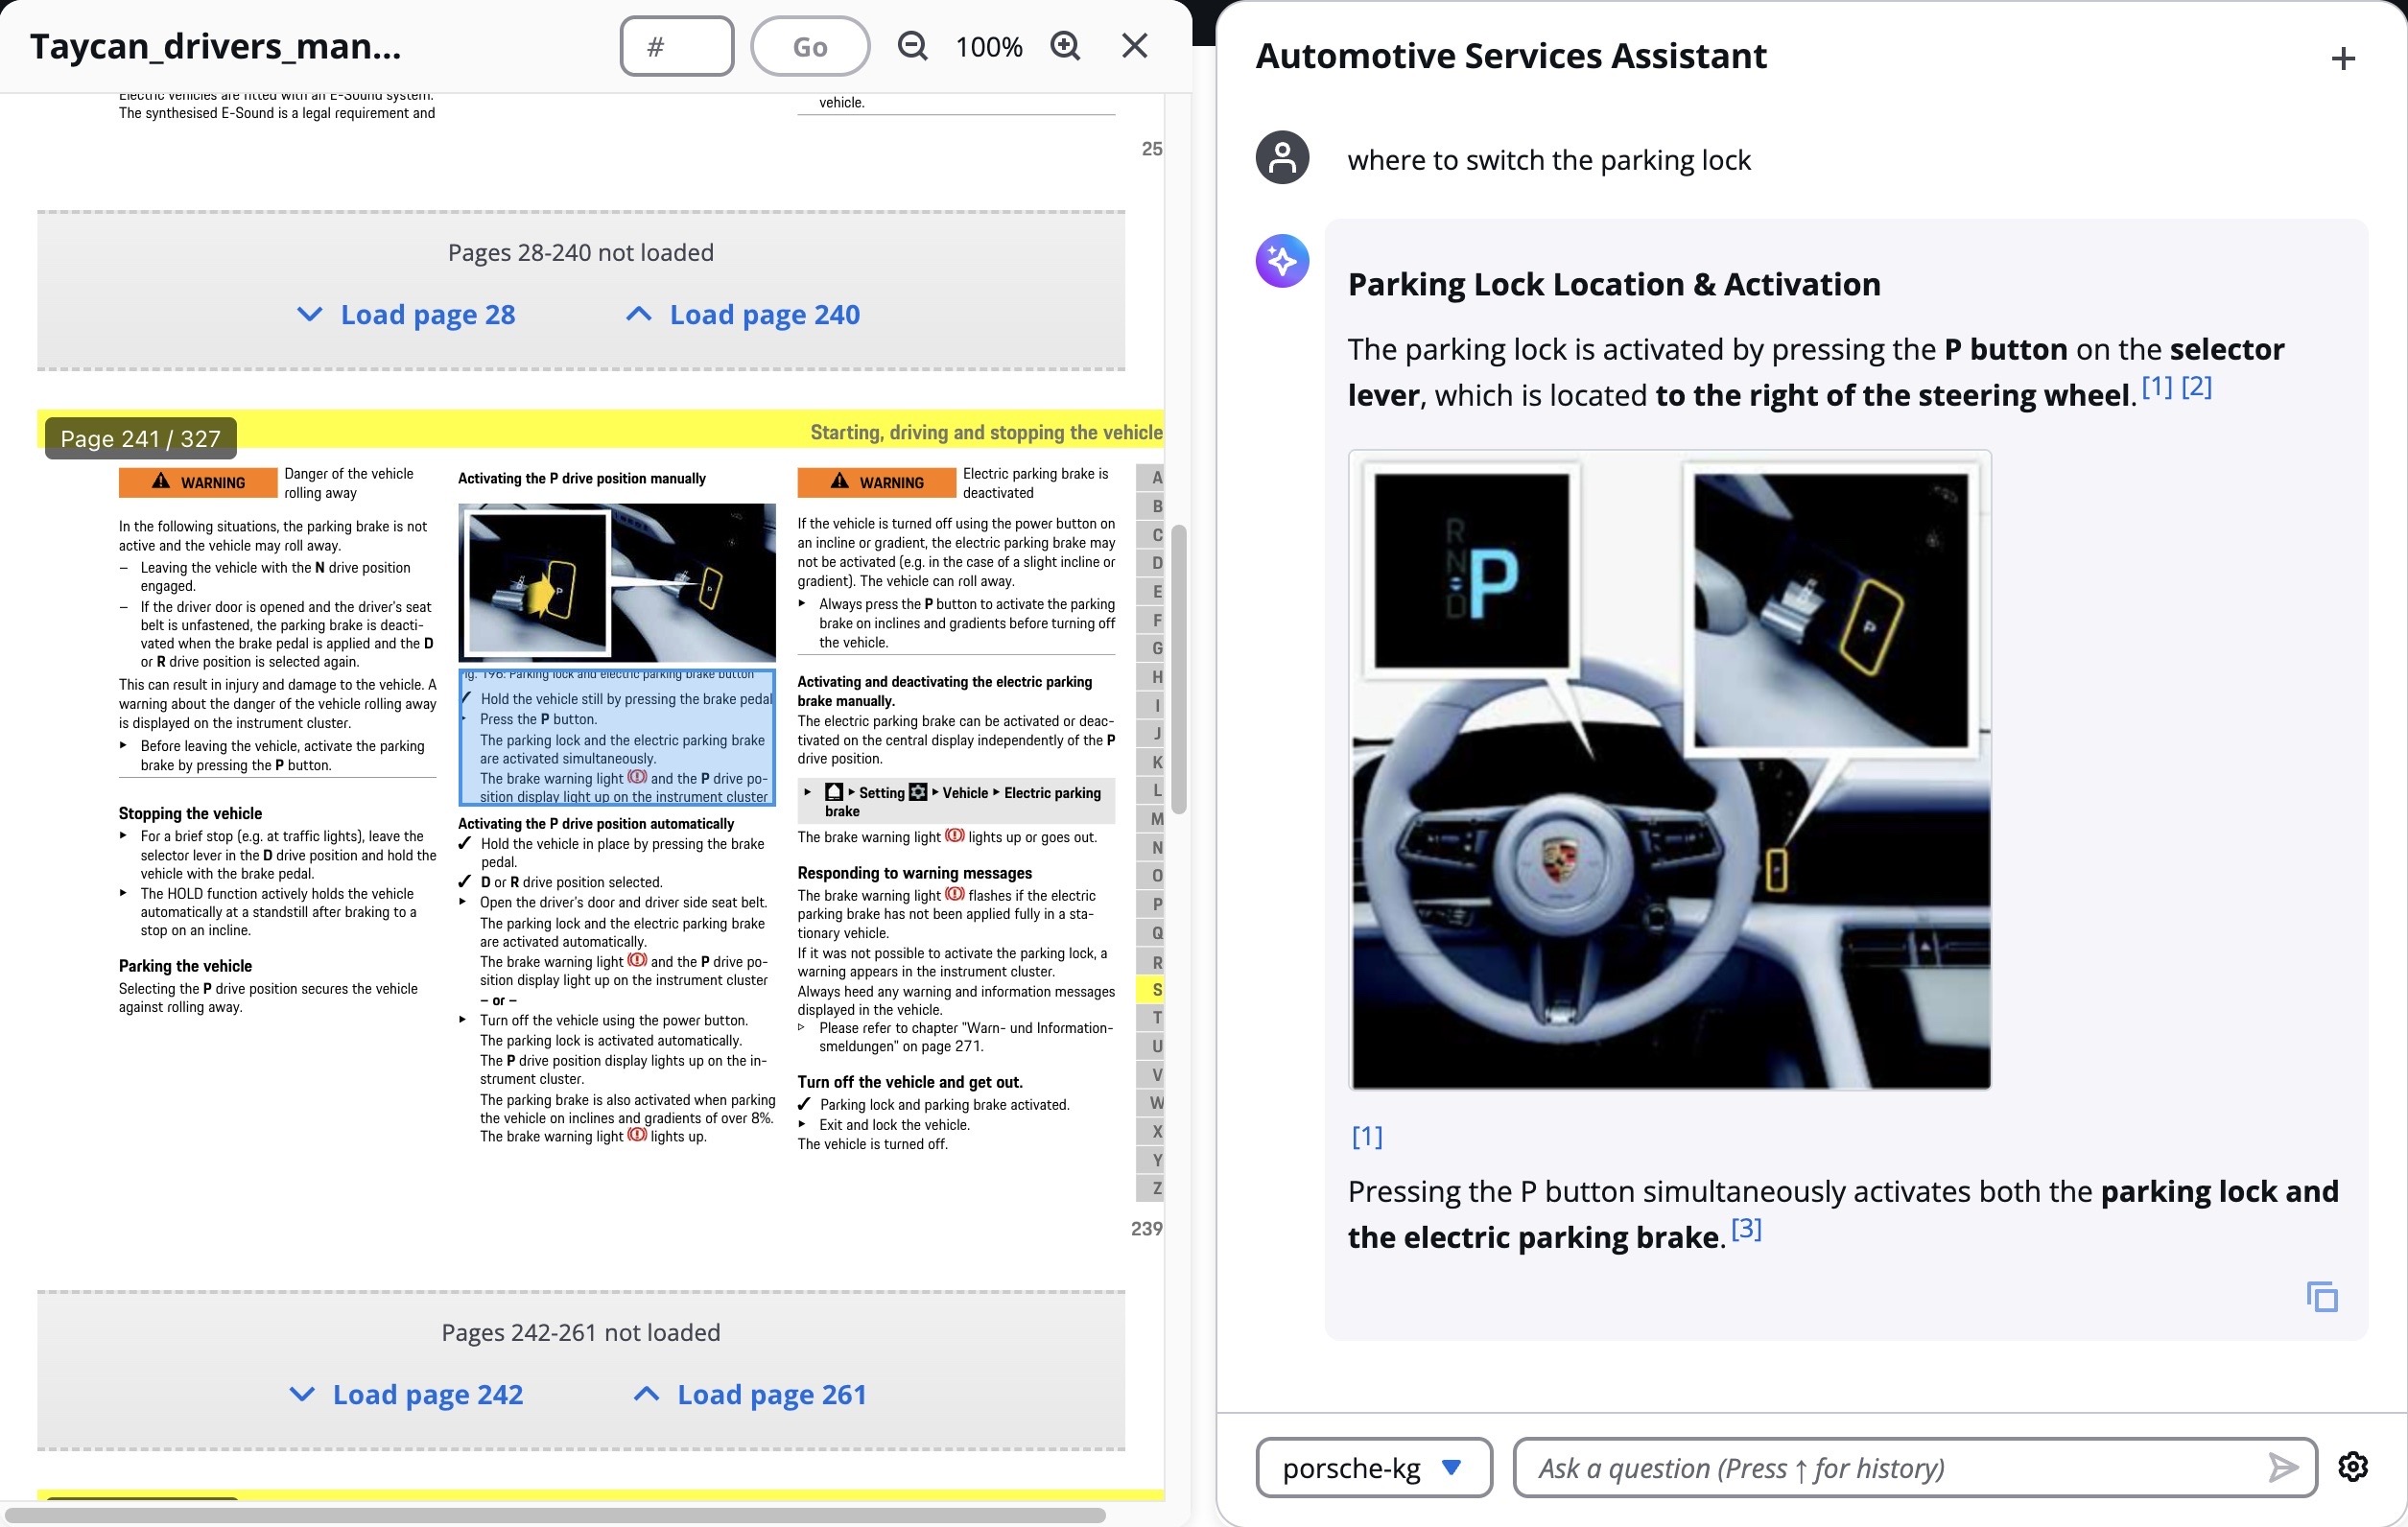
汽车OEM手册:复杂多栏PDF布局溯源
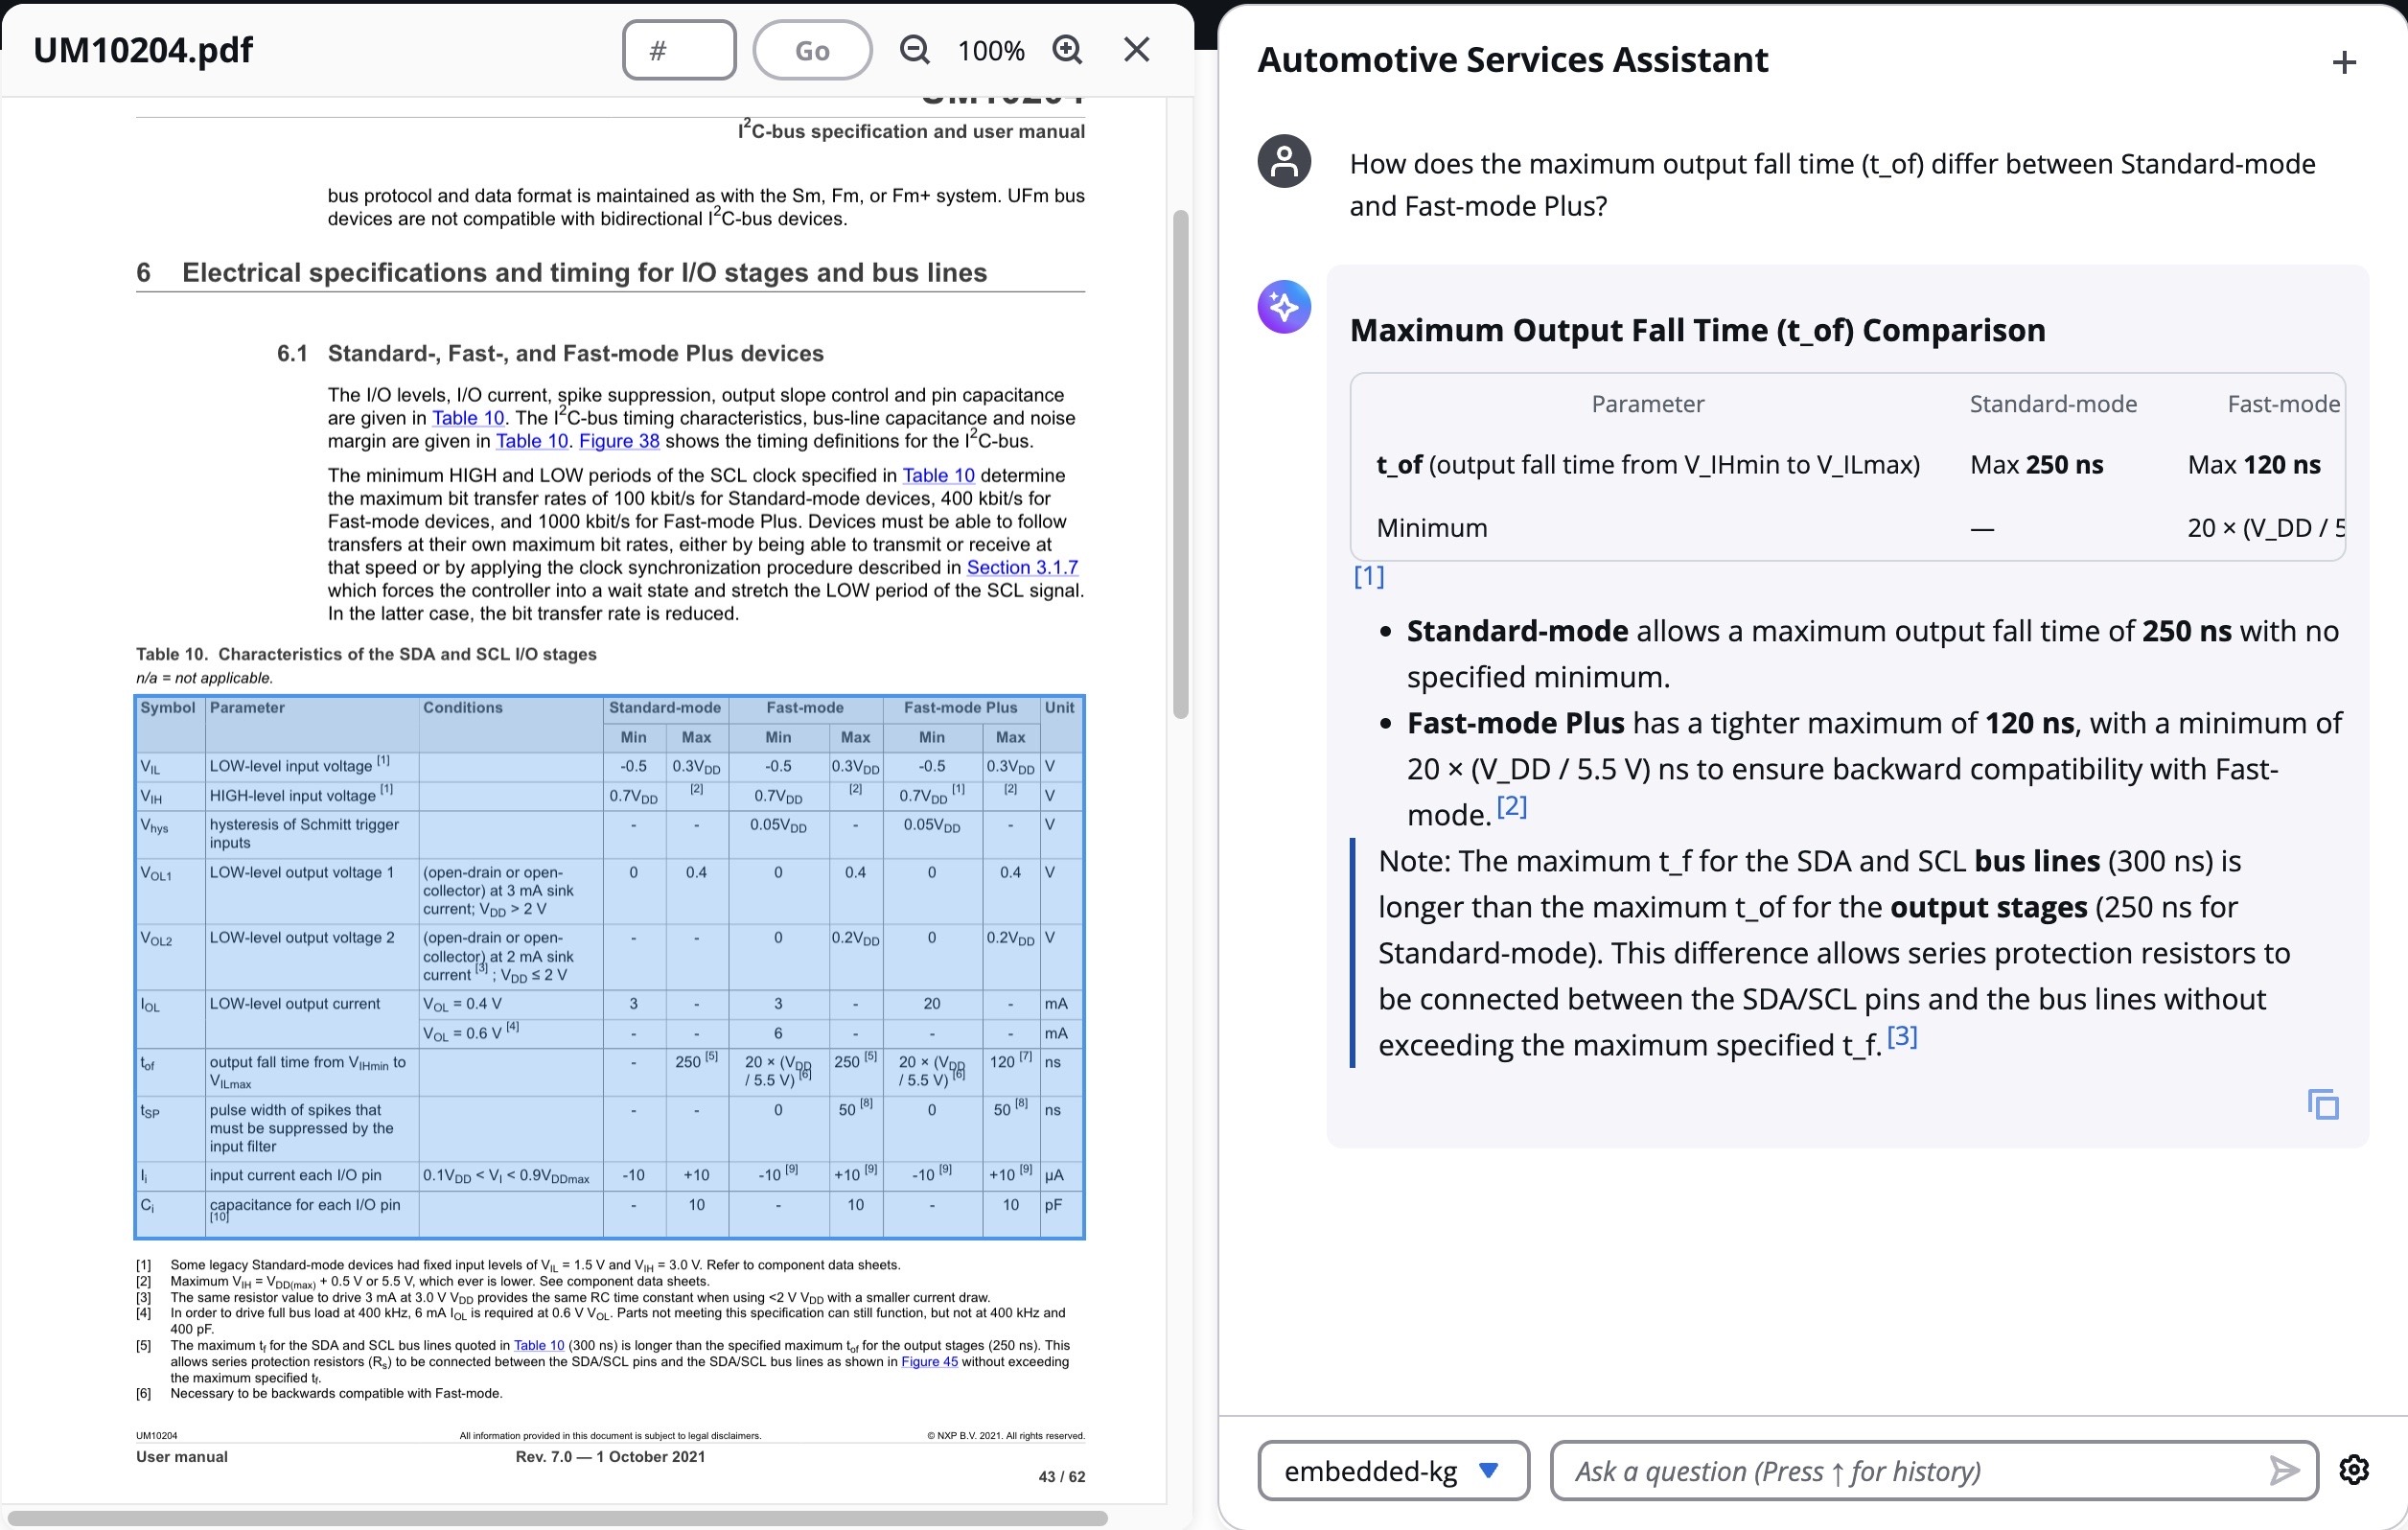
嵌入式系统(I2C):含合并单元格的复杂数据手册表格溯源
行级溯源背后的两个硬核技术难题
✕PDF 解析器为每个文本元素标注了 BBox 坐标。传统固定 token 分块会把坐标标签从中劈开,导致行级溯源彻底不可能。
✓倒转范式:向上聚合,而不是向下切分。从最底层的 PDF 对象 JSON 序列开始,逐级向上聚合到配置的分块大小——从设计上根除了破坏任何坐标边界的可能。
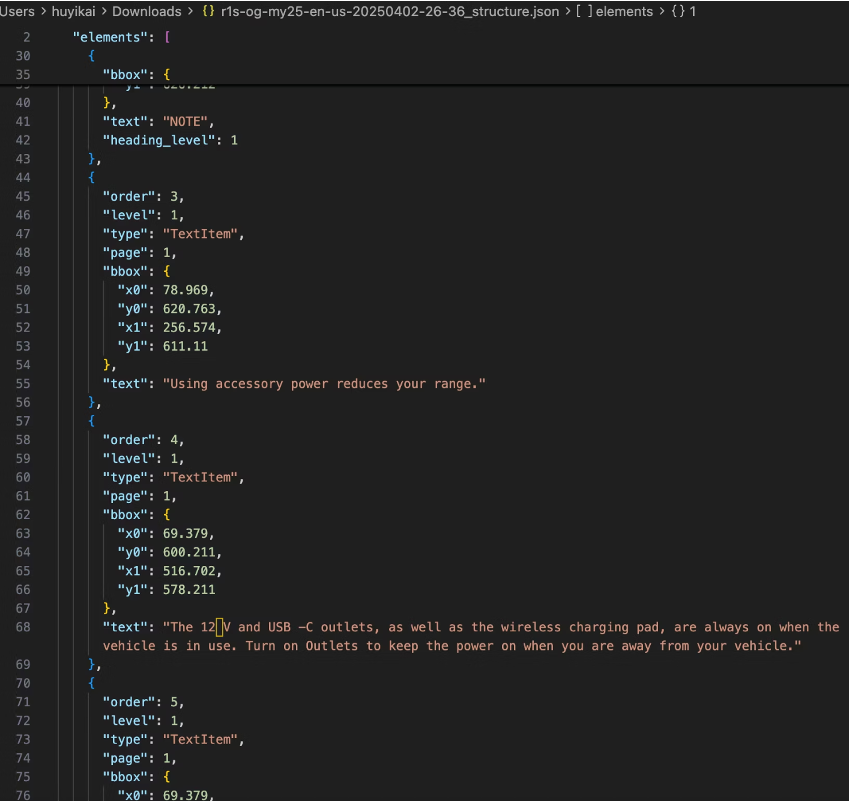
PDF 最底层的解析结果——每一个 bullet 都带着自己的页码和边界框坐标
✕PDF 里每个列表项、每个小段落都有独立的坐标。直接用它们溯源,一次点击就会在页面上撒出一堆零散的小高亮——验证体验极差。
✓语义级 BBox 合并。以表格、图像、章节标题作为语义边界,把边界之间的连续文本元素合并为一个完整的语义单元。点击引用后高亮的是一个有意义的段落,而不是满页五彩碎纸。
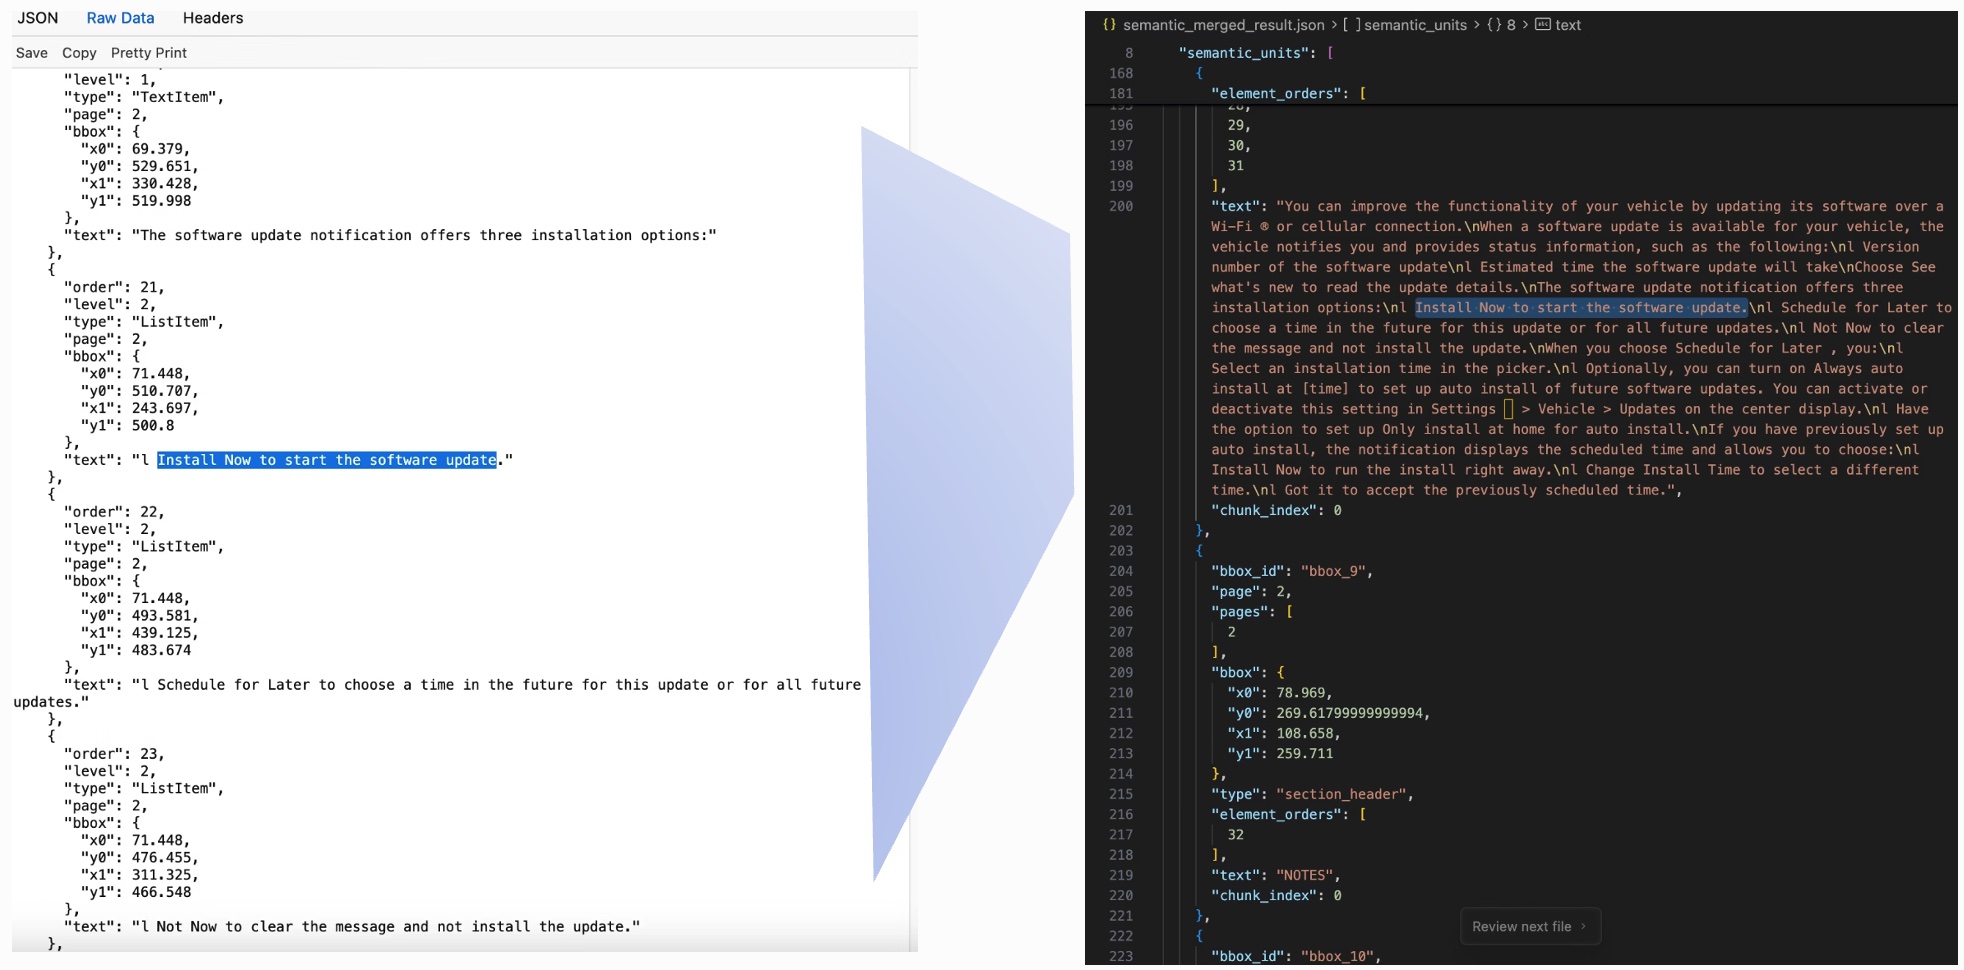
语义级 BBox 合并——把碎片化的元素级边界框合并为完整的语义单元
Benchmark:两层验证
平台经过两轮 Benchmark 验证——一轮内部受控实验,用于隔离图谱层本身的增益;一轮由客户主导的四方竞标,对标市面上最强的替代方案。
基于 LightRAG,在一本代表性汽车用户手册上进行28题评测,对比 Graph + Vector(Mix 模式)与 Vector-only(Naive 模式)在5个 LLM 上的 Win/Lose/Tie 表现。图增强方案在全部5个模型上都赢——证明增益来自图谱层本身,与基座模型无关。
由一家头部商用车 OEM 客户在其3,000+页服务手册上出题并亲自评分的100题 Benchmark。四方并行评测:Azure GraphRAG、阿里云、开源 RAGFlow,以及一家国内大学研究团队。结果:95%+ 准确率对比次席 ~80%——在竞标中被重新包装为“每100次查询减少15次错误维修”,正是这句话促成了合同签订。
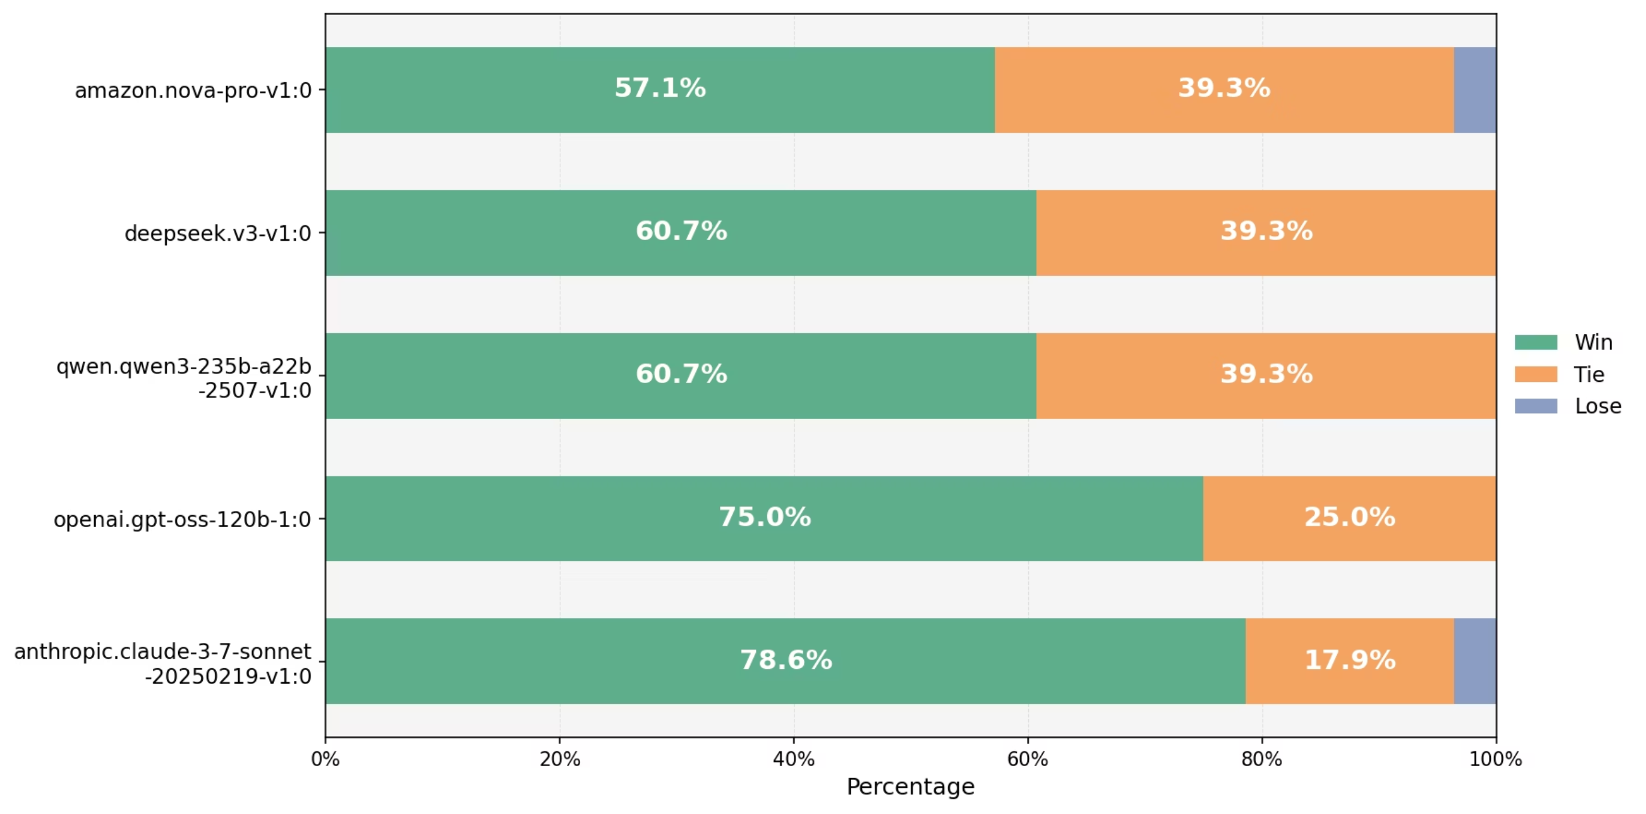
内部 Benchmark 结果:Graph + Vector vs Vector-only——5种 LLM 模型的 Win/Lose/Tie 评测
MCP 扩展——跨行业集成
FastMCP服务器通过OIDC(Cognito)和API密钥双重认证暴露7个知识库工具——支持与客户现有智能体框架(Dify、LangGraph、Strands SDK、AgentCore)的即插即用集成。演示:Kiro IDE集成生成嵌入式I2C代码——展示方案在汽车以外的跨行业适用性。
MCP演示:Kiro集成,从知识库生成嵌入式I2C代码
系统总览:Ingestion 与 Retrieval Pipeline
两条流水线、一套双轨索引——文档入库时同步写入图+向量混合存储,查询时并行检索两条路径。
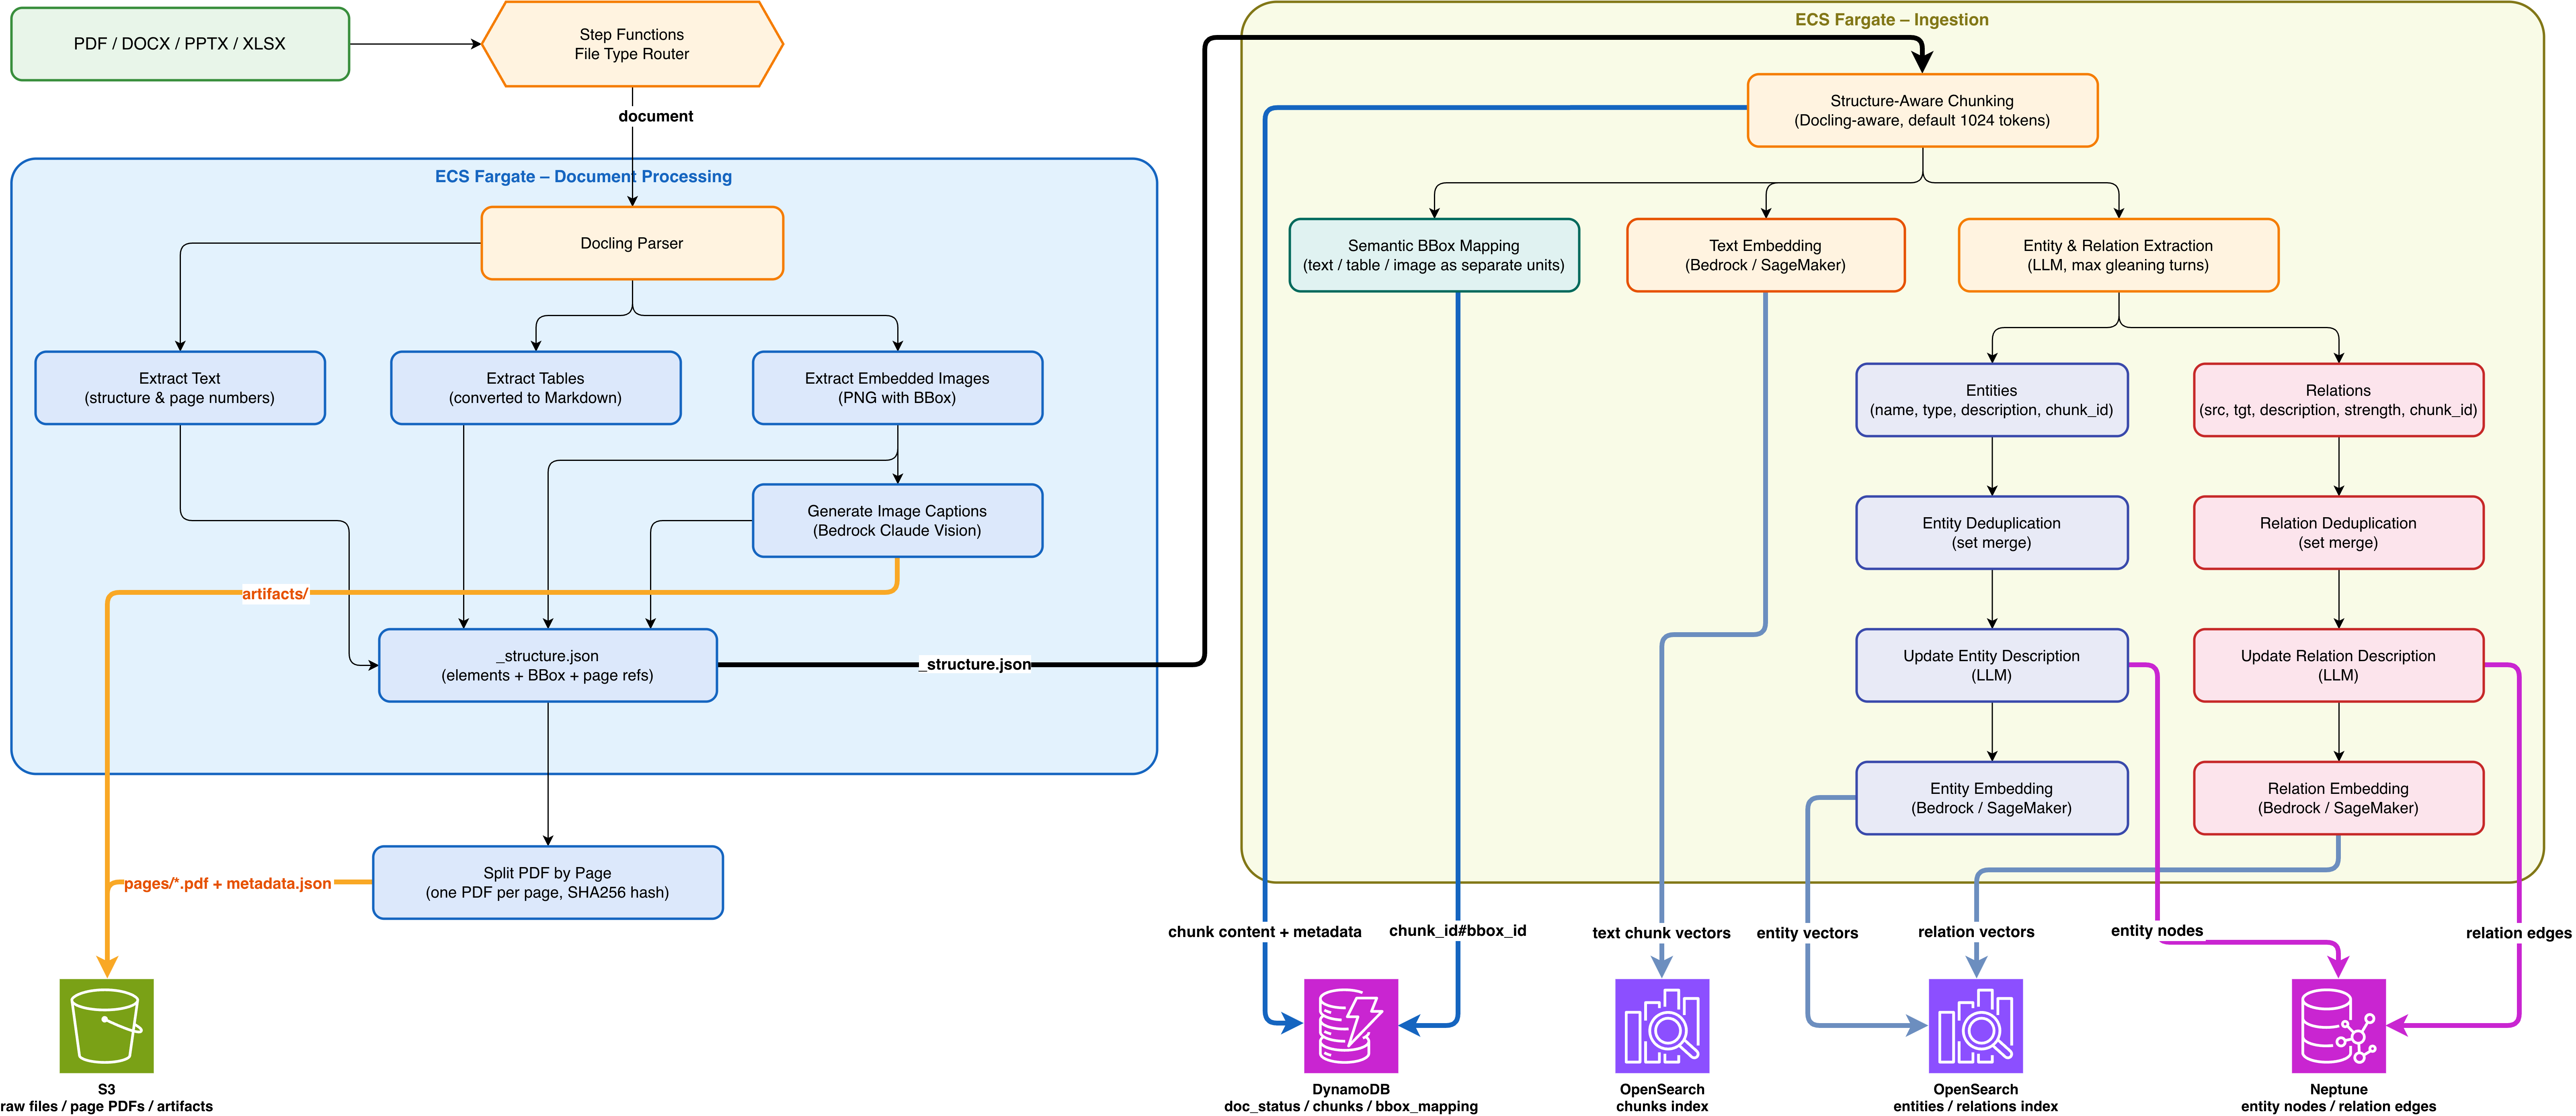
Ingestion Pipeline——LLM 驱动的解析、实体与关系抽取、双轨存储到 Neptune(图)与 OpenSearch(向量)
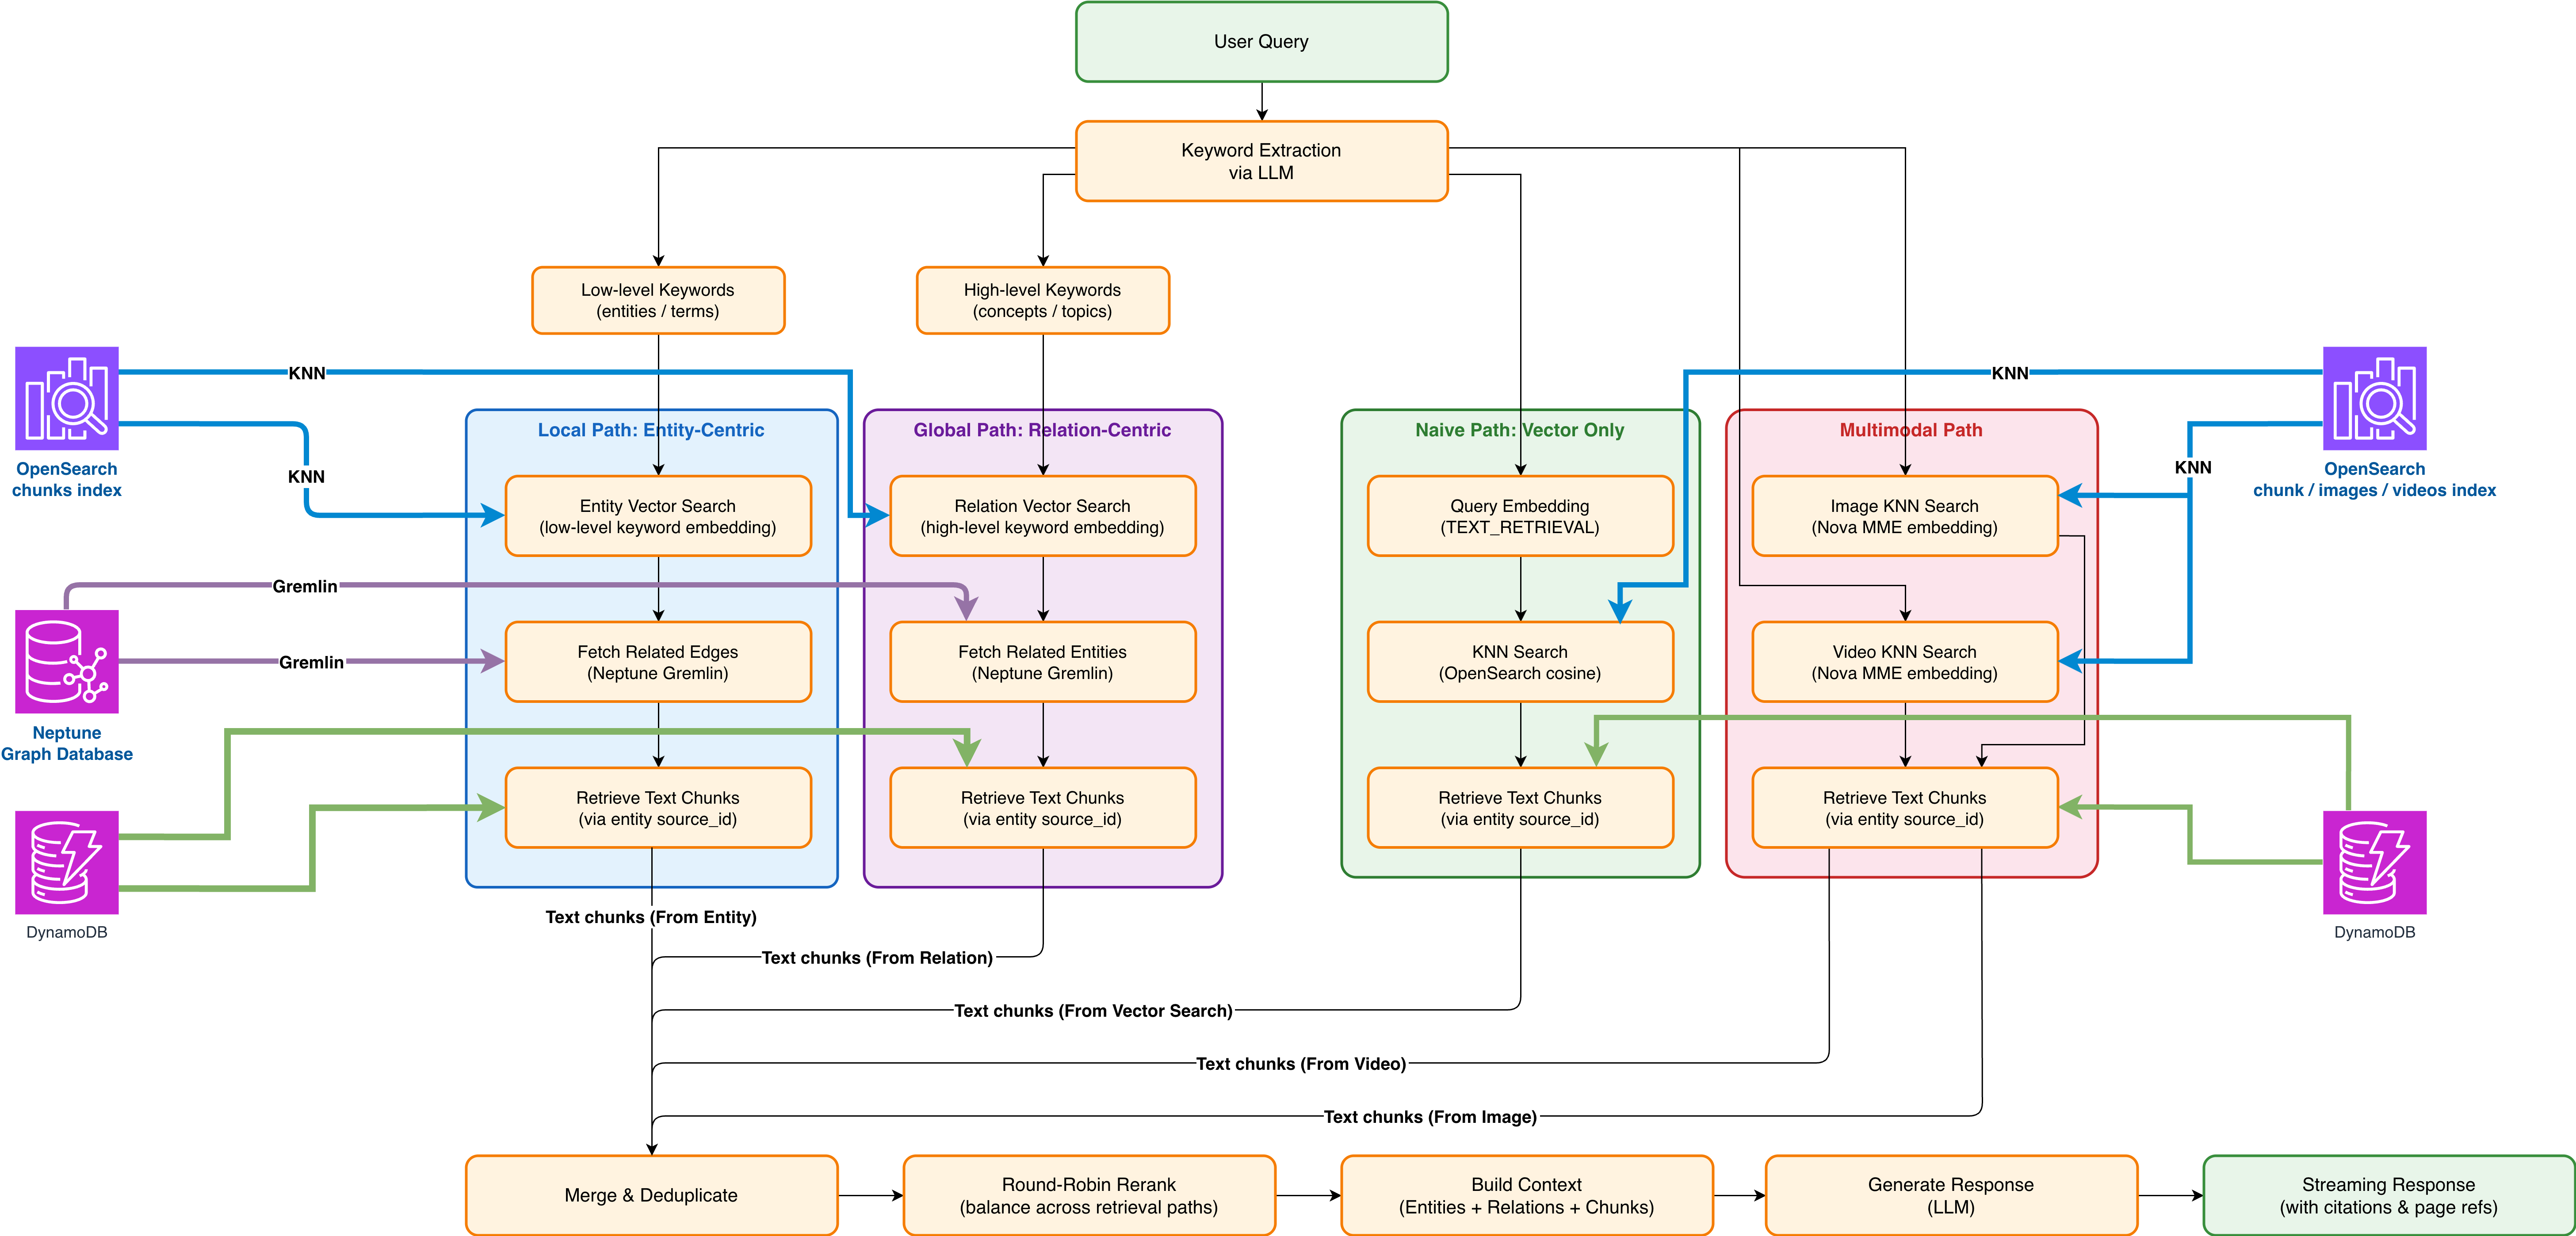
Retrieval Pipeline——双路径检索(图 + 向量)、结果融合、带边界框溯源的 LLM 回答生成
存储层:每个数据住在哪
四个 AWS 托管服务,各司其职。四层存储均通过 context_id 实现多租户数据隔离。
- ›实体顶点——名称、类型、描述
- ›关系边——带类型和描述的 source→target
- ›支撑 Graph Search 的多跳遍历能力
- ›Chunk 文本 + Embedding 向量
- ›实体描述 Embedding
- ›关系描述 Embedding——三索引并行向量搜索
- ›BBOX_MAPPING —— chunk_id + bbox_id → 页码与坐标(行级溯源的数据基石)
- ›全量文档文本、分块记录、实体与关系表
- ›文档处理状态 + LLM 响应缓存
- ›原始上传文档(PDF / Word / PPT)
- ›按页切分的 PDF——供前端溯源查看器
- ›Docling 解析产物 + 提取的图片 + DynamoDB 溢出内容(>200KB)
系统架构
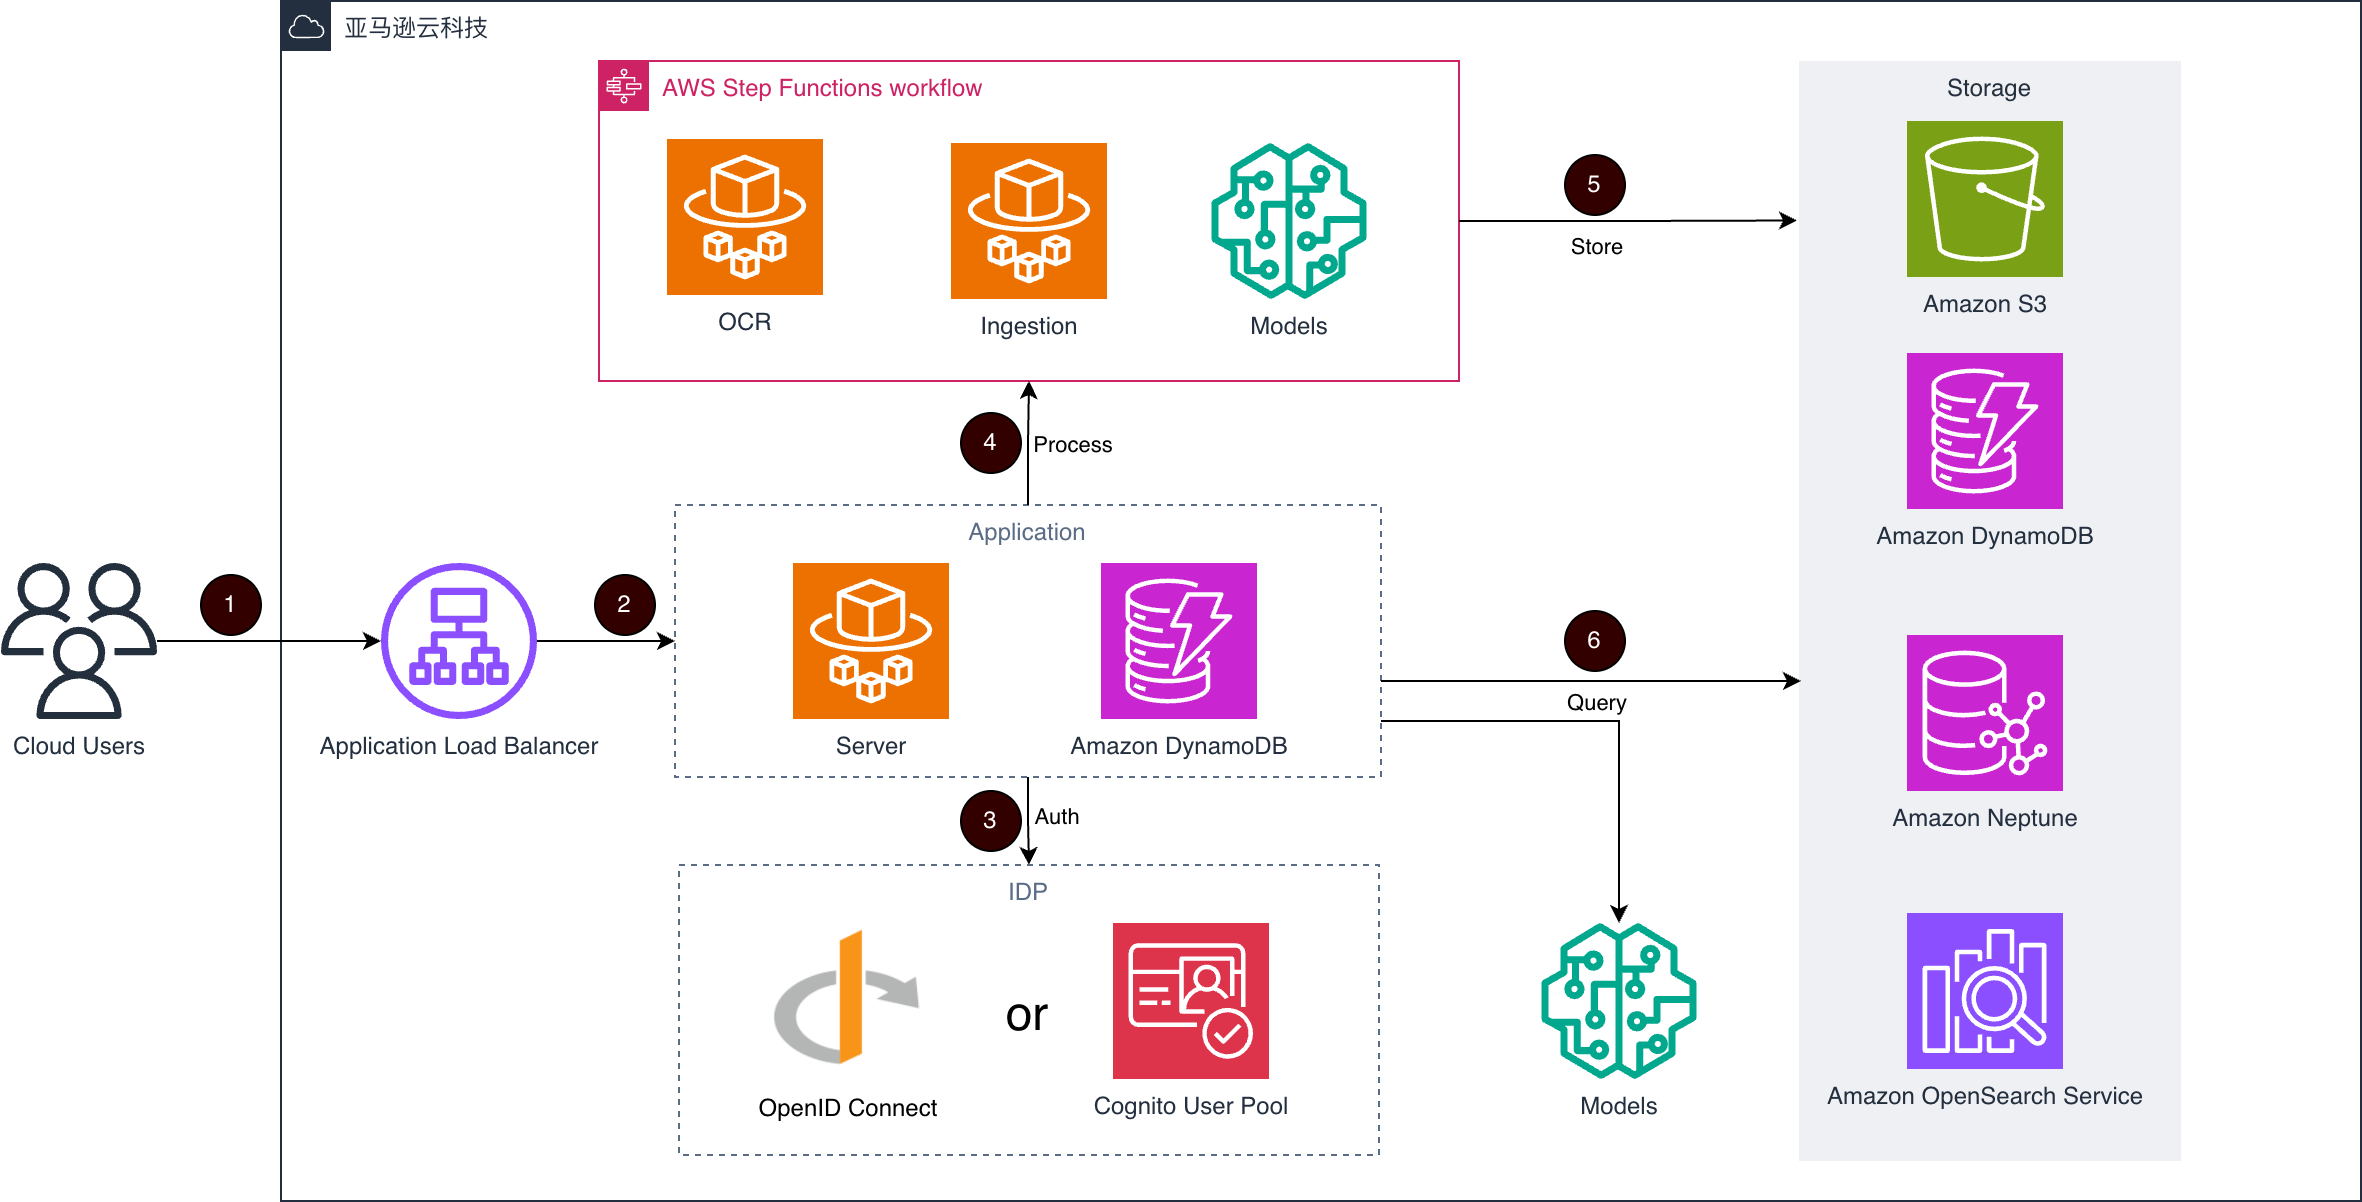
基于AWS托管服务的混合图-向量架构:Neptune知识图谱 + OpenSearch向量检索 + DynamoDB元数据
项目数据
竞争优势
在3,000+页技术手册的100题客户主导 Benchmark 上达到95%+准确率——在召回、多跳推理和复杂表格检索三个维度超越 Azure GraphRAG、阿里云、开源 RAGFlow 及一家国内大学研究团队。
边界框级别 PDF 引用系统提供行级来源溯源——在竞争性客户转化中被一致引用为决定性因素,并在客户沟通中被重新包装为“每100次查询减少15次错误维修”。
从LightRAG单节点设计重新架构为全托管AWS原生架构(Neptune + OpenSearch + DynamoDB + S3),支持无单点故障的企业级部署——这是26% POC到生产转化率背后的产品化基座。
技术栈
图AI与搜索
AI/ML与编排
后端与数据
文档与媒体处理
基础设施与部署
展示内容均基于公开信息或脱敏数据处理。