企业级AI文档翻译平台
企业级AI翻译平台,为领先医药和医疗器械企业提供97%术语准确率(200万+医学术语)、92%品牌语调一致性和98%格式还原精度。服务3家头部医疗企业,通过技术竞争优势击败现有供应商——在AWS Summit China 2025作为特邀演讲嘉宾,演讲后新增10+商业合作机会。
翻译功能演示
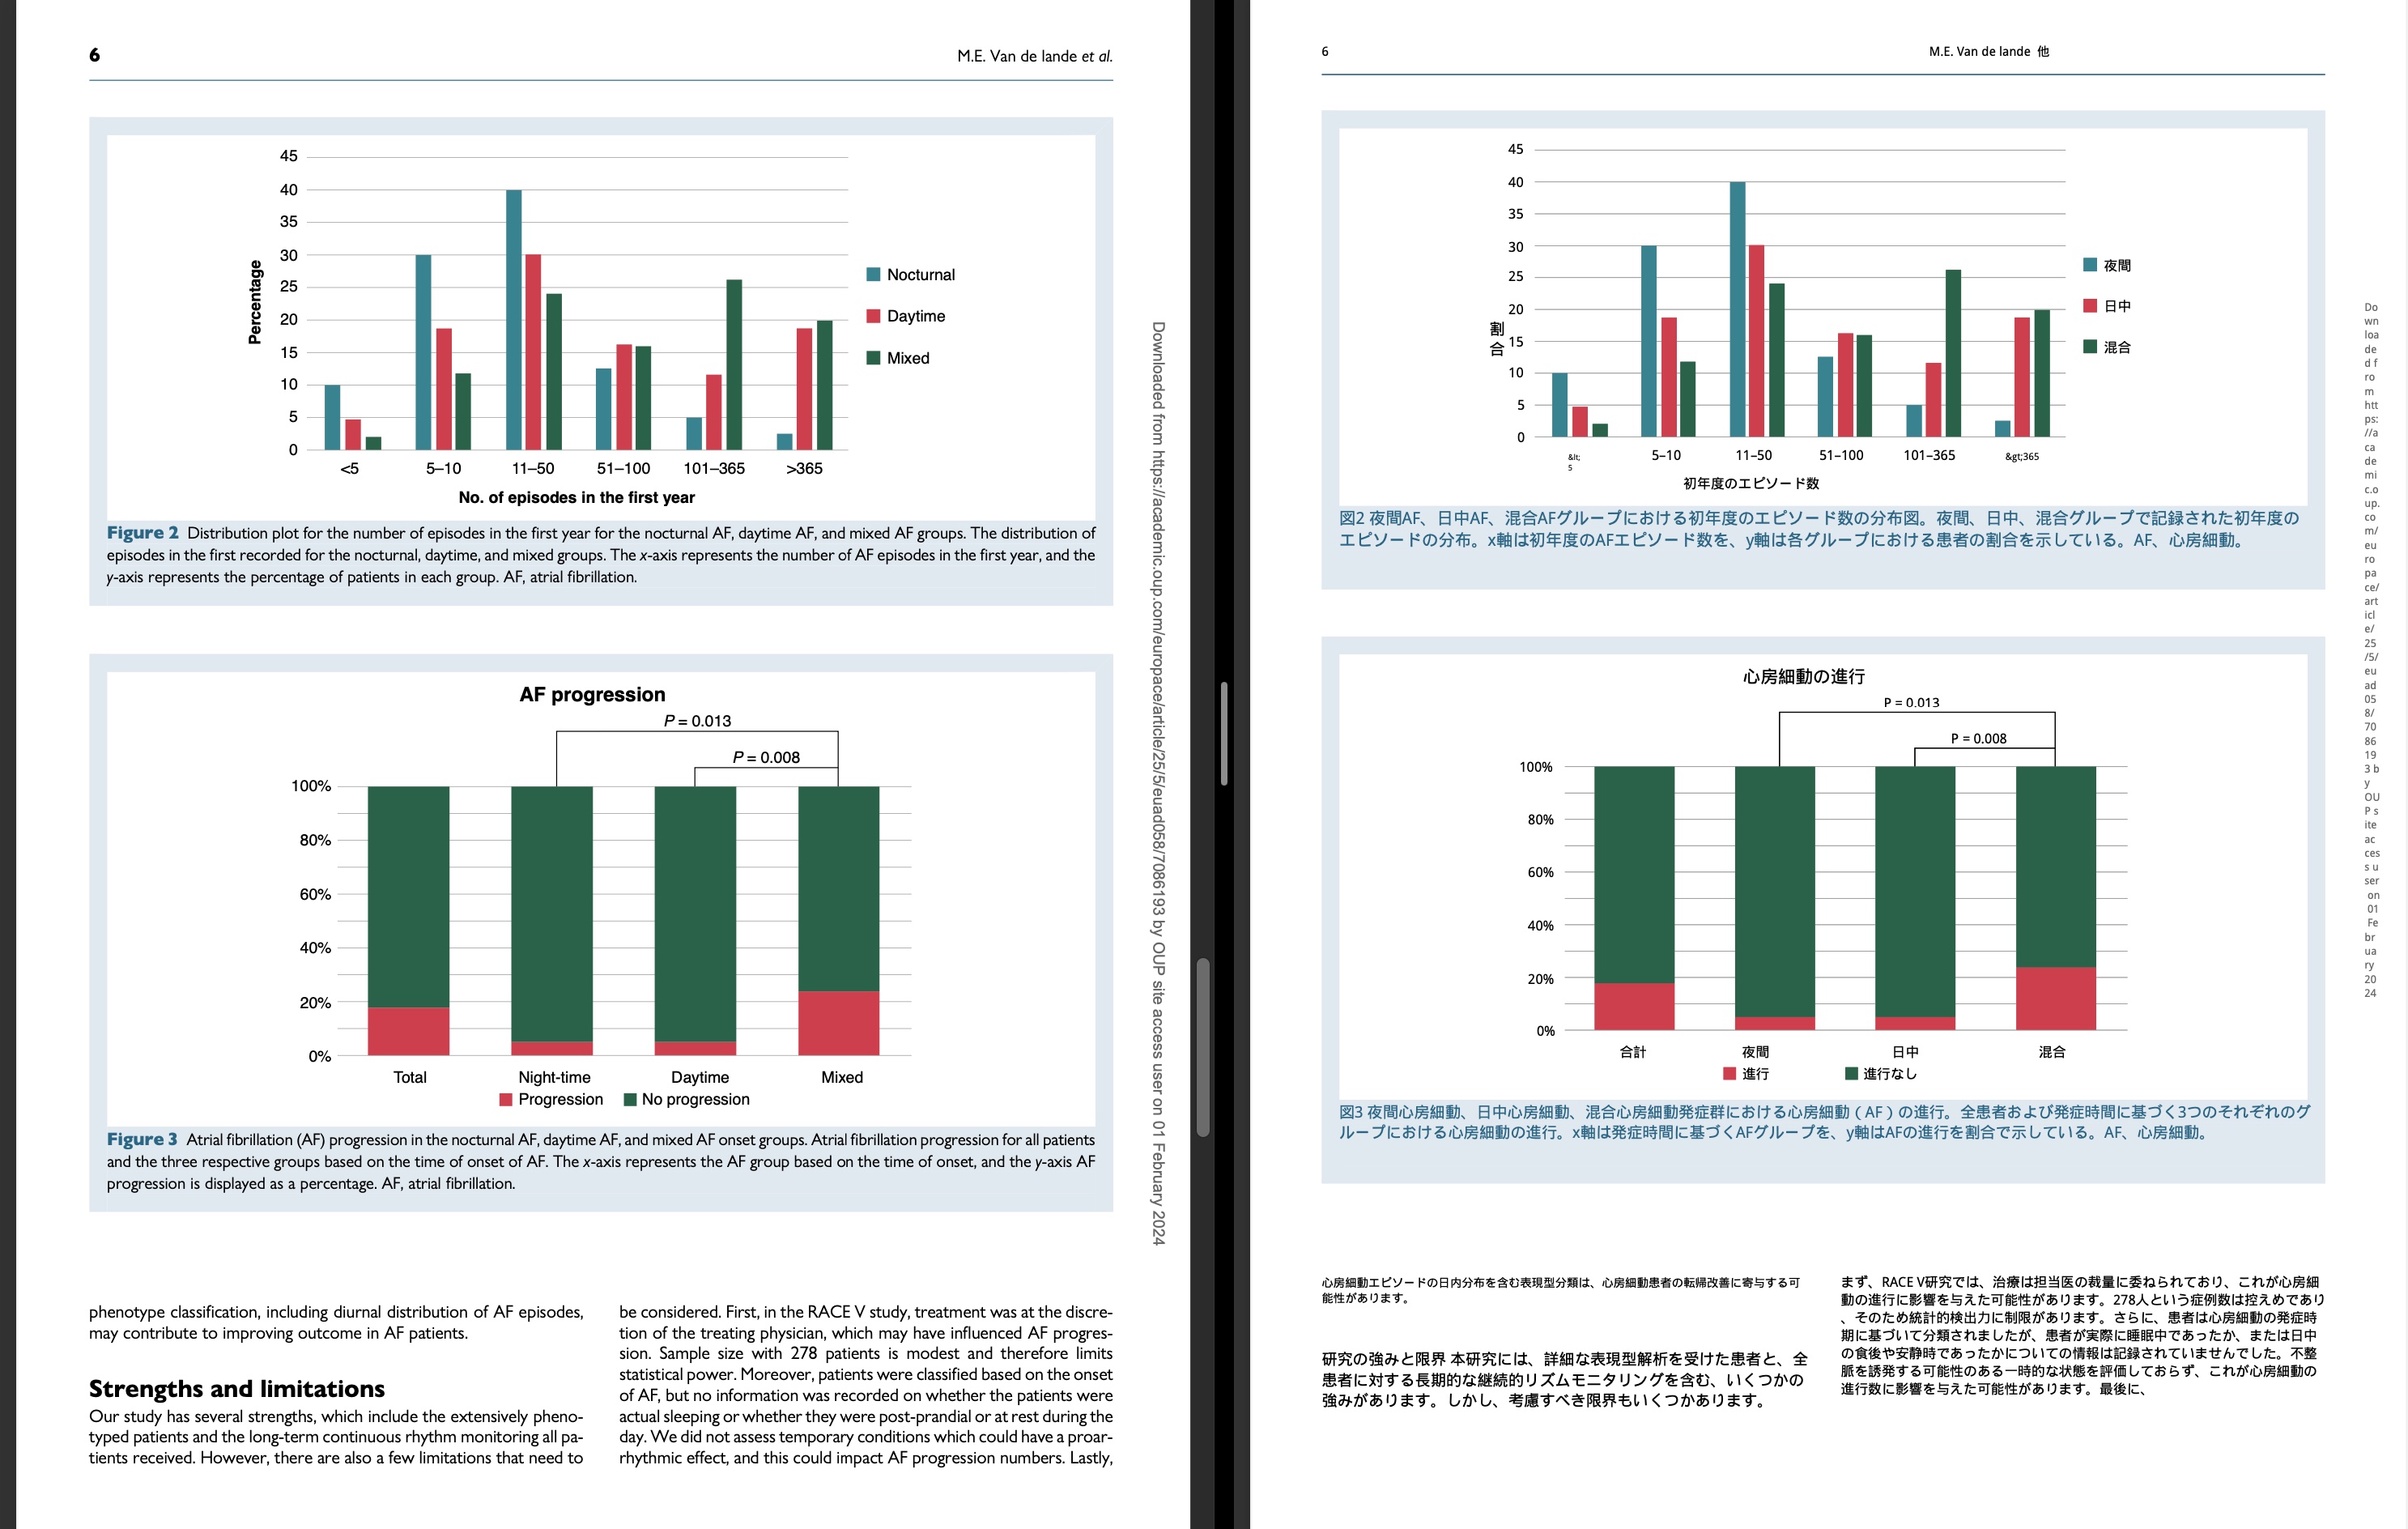
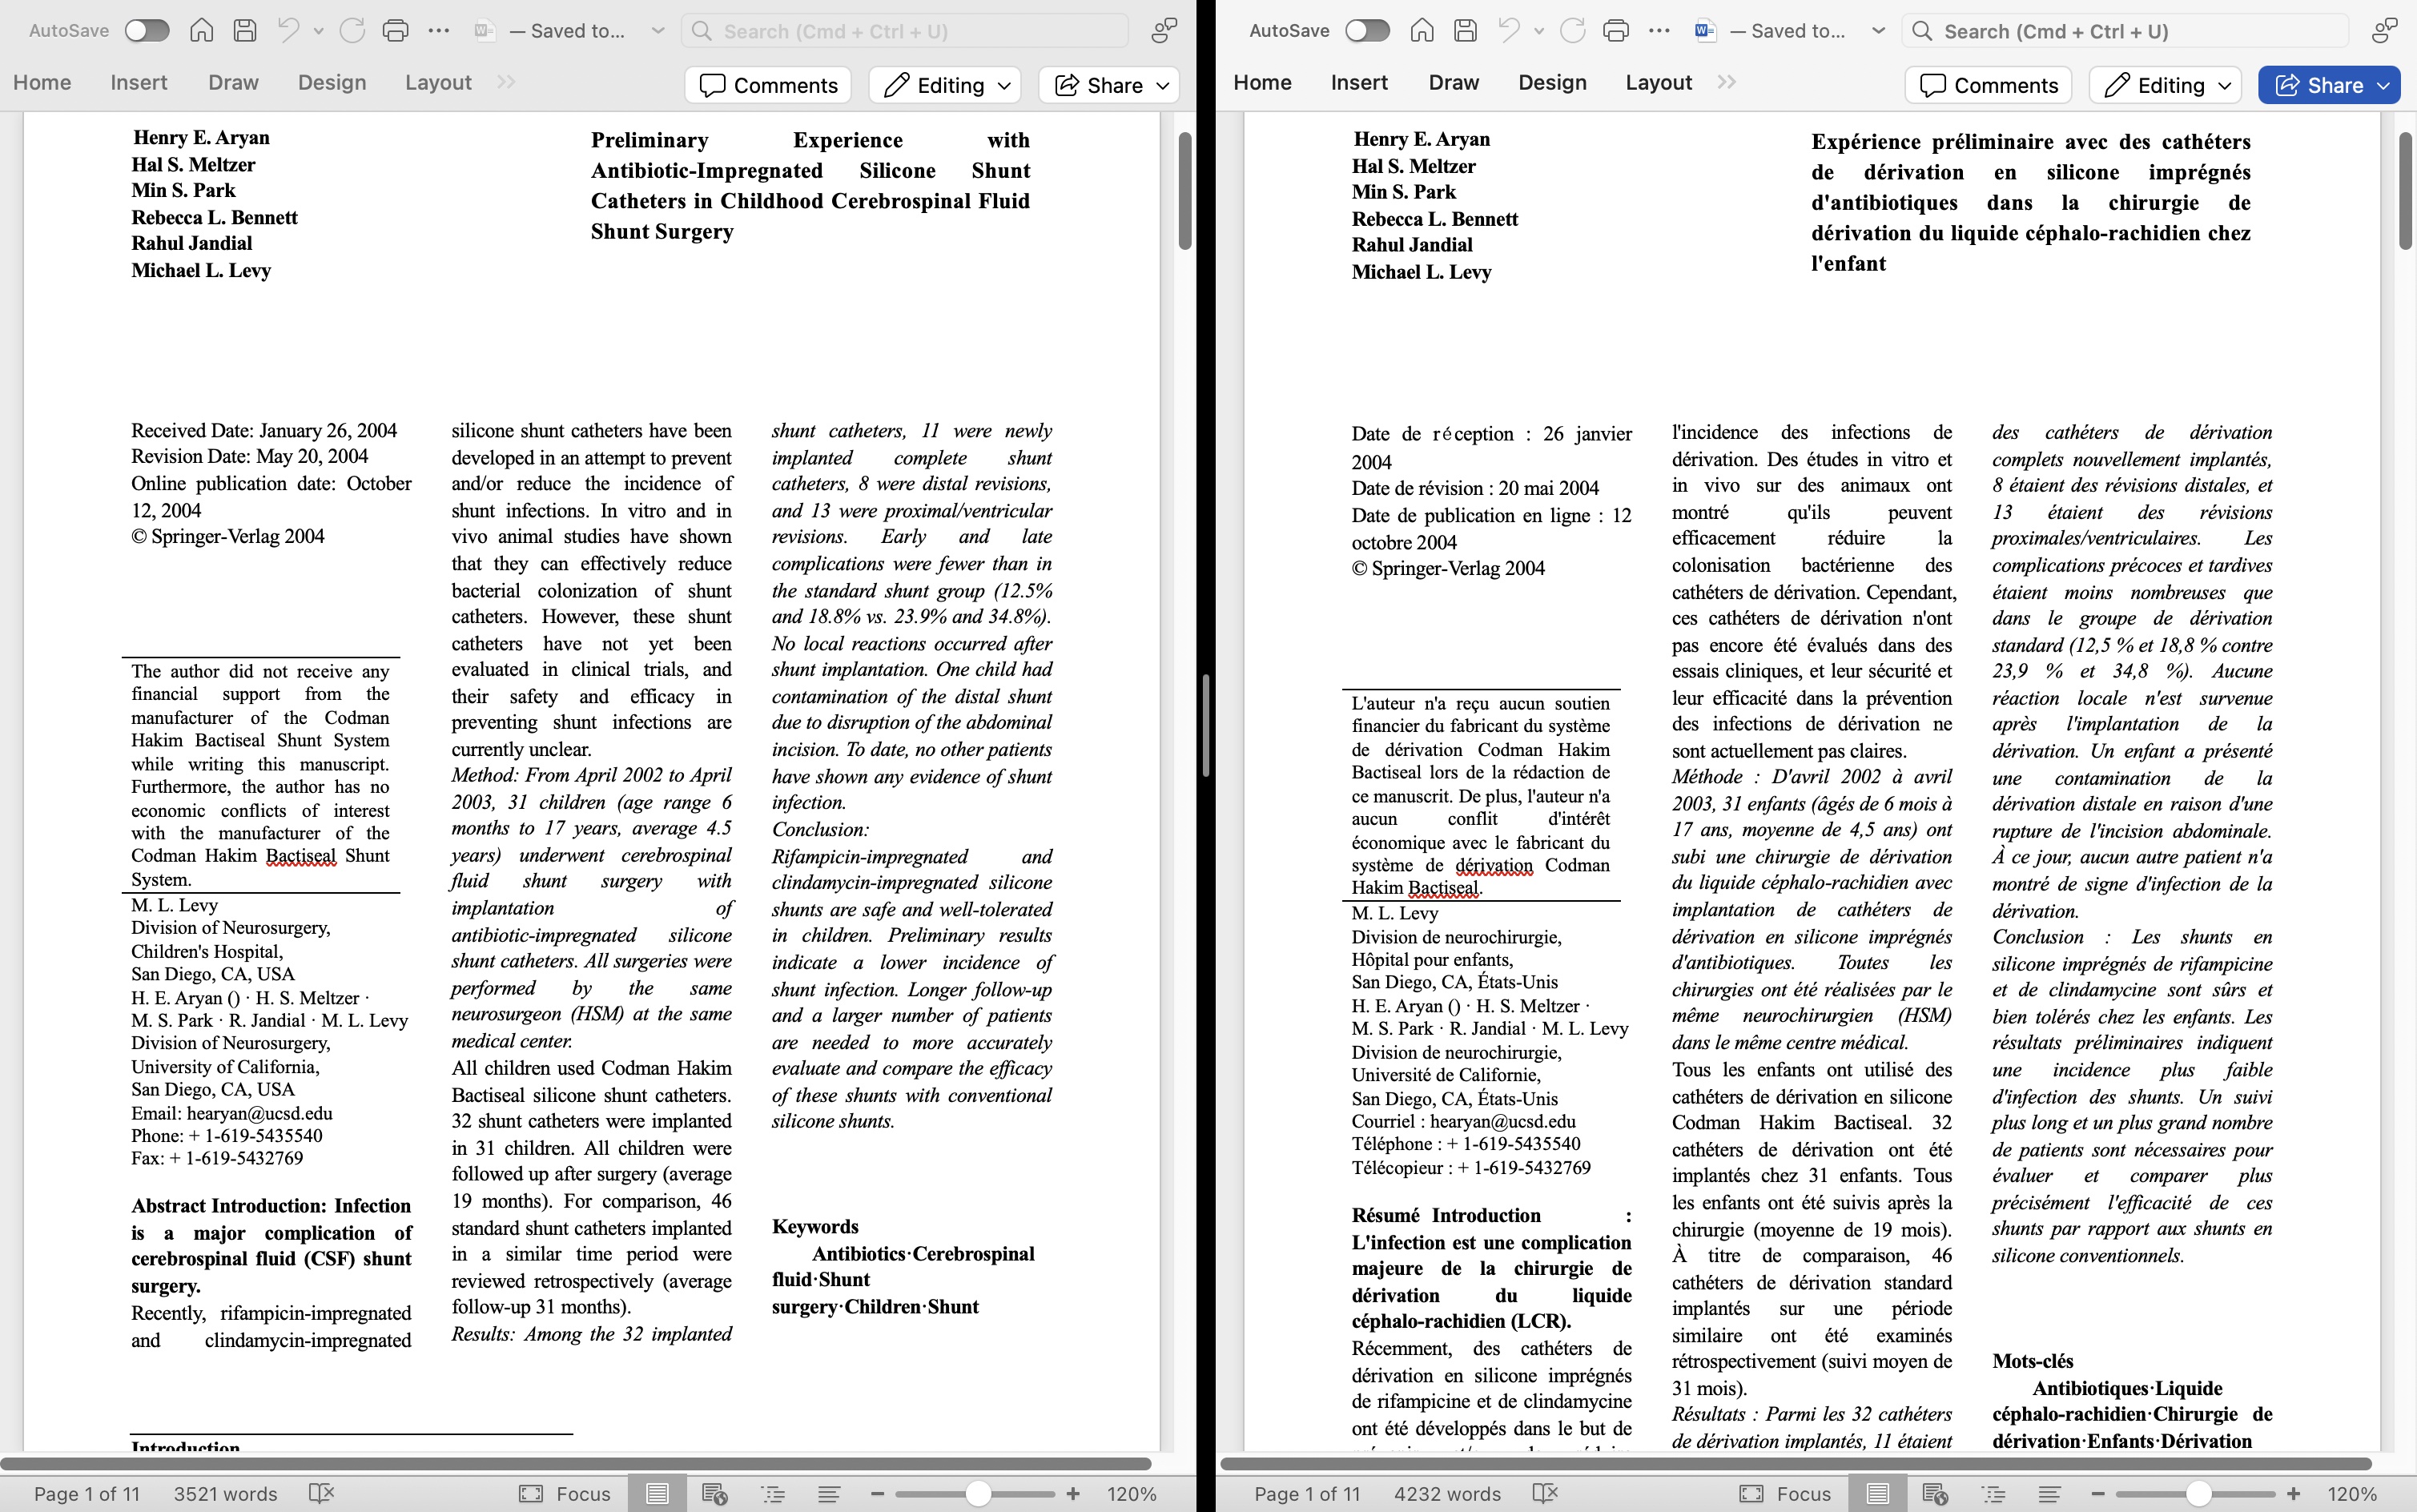
PDF: Academic Paper (English to Japanese)
用户体验演示
完整工作流演示:从文档上传到术语增强翻译输出的全流程
项目概述
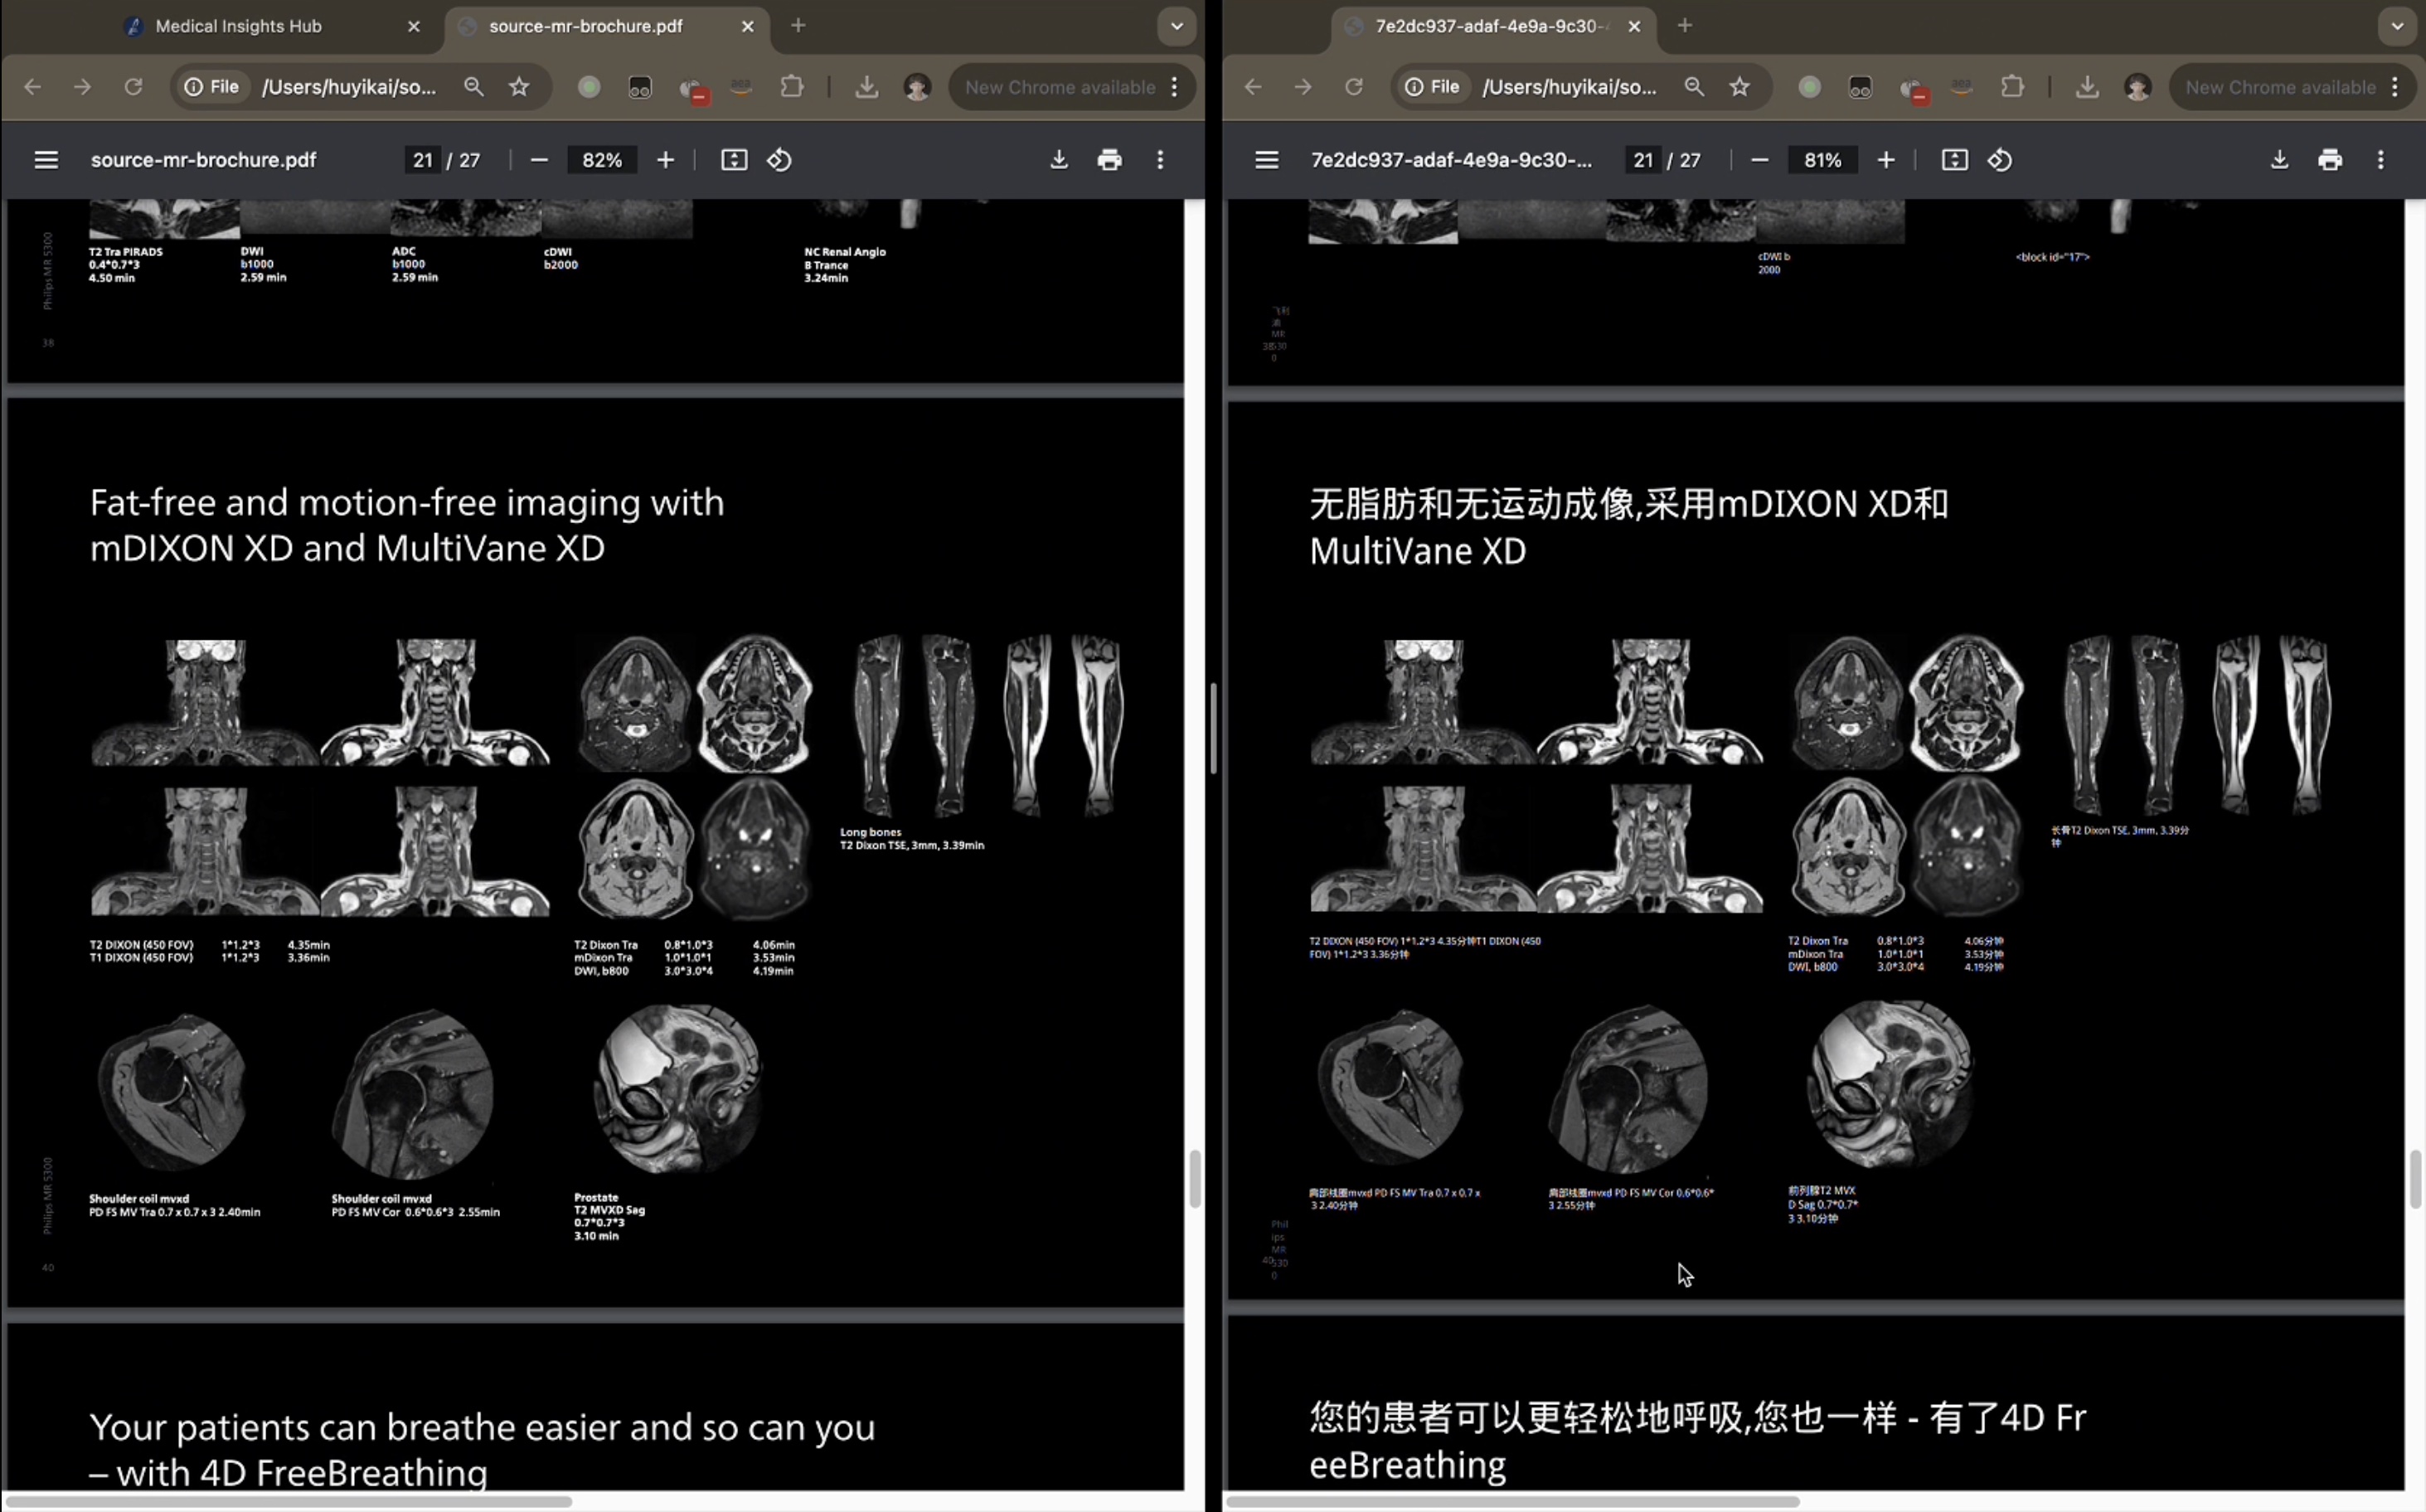
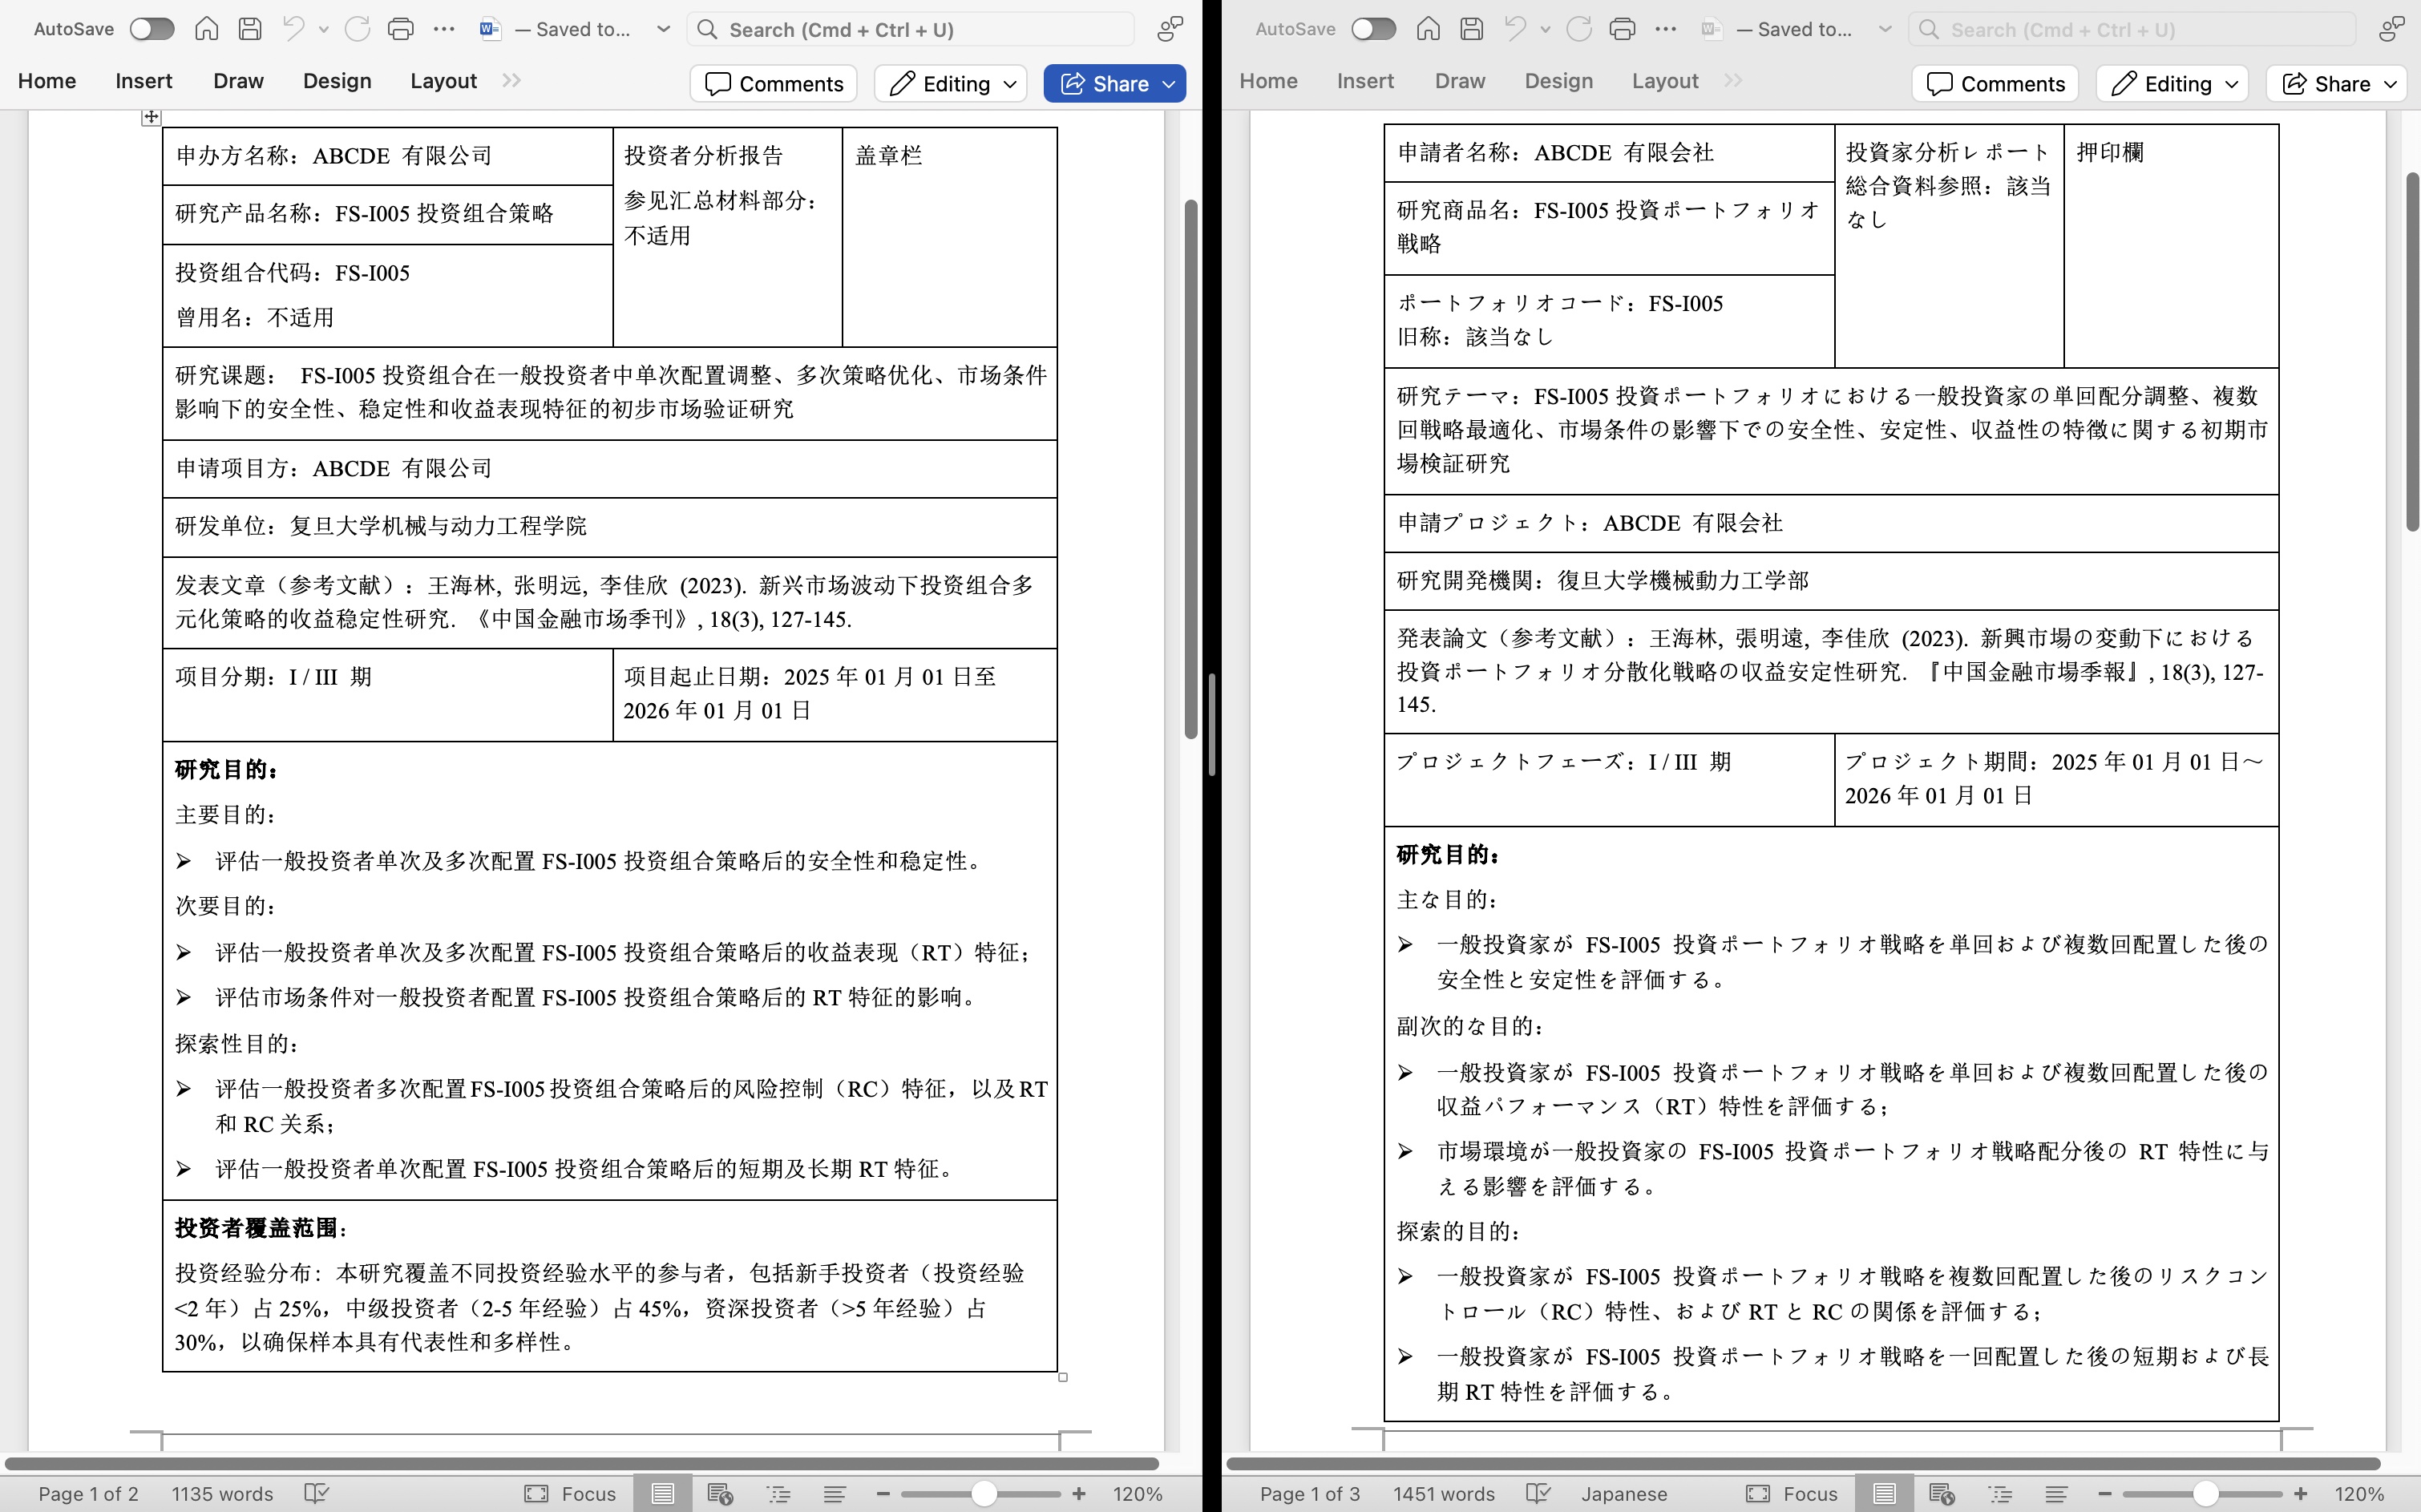
一个专为医药和医疗器械企业设计的智能文档翻译平台,服务于有复杂专业术语和严格合规风格要求的客户。从行业头部医药公司的试点项目起步,通过技术竞争优势扩展至3家主要医疗企业——在术语准确率、品牌语调一致性和格式还原方面超越现有供应商,赢得竞争性RFP。平台处理医疗器械手册、法规文件和学术论文,同时跨语言保持像素级精确的排版格式。
核心技术特性
使用OpenSearch Percolator为WhoDrug数据库中的200万+医学术语构建术语匹配系统。实现97%准确率,将500页文档翻译时间从数周缩短至30分钟。自适应多尺度匹配:小数据集用AC自动机,中等规模用OpenSearch Percolator模糊匹配,大型制药数据库用自定义分词增强OpenSearch。
构建结合BM25和向量嵌入的混合RAG架构,配合风格迁移算法,在制药客户中实现92%的品牌语调一致性。特性包括历史翻译语料分析、基于内容相似度的智能风格模式检索,以及从专业译者反馈中持续学习。
构建空间解析算法,处理中英文文本扩展(40%长度差异),同时为法规文件保持98%的视觉格式准确率。先进的PDF渲染采用字体收缩和块合并算法,基于XML的Word文档处理保留表格结构、字体样式和复杂元素。
主导多模型服务架构技术设计,使用vLLM和LiteLLM在分布式GPU集群上支持6+大语言模型(Llama、Qwen、DeepSeek)。构建可扩展的FastAPI微服务,配合ALB、ECS Fargate容器化和DynamoDB状态管理,实现无缝模型切换和负载均衡。
基于AWS CDK的基础设施即代码,实现一键部署:无服务器架构包含Lambda函数、Step Functions编排、自动扩缩容和集成监控。从基础设施配置到服务配置,20分钟内完成全系统部署。
翻译工作流
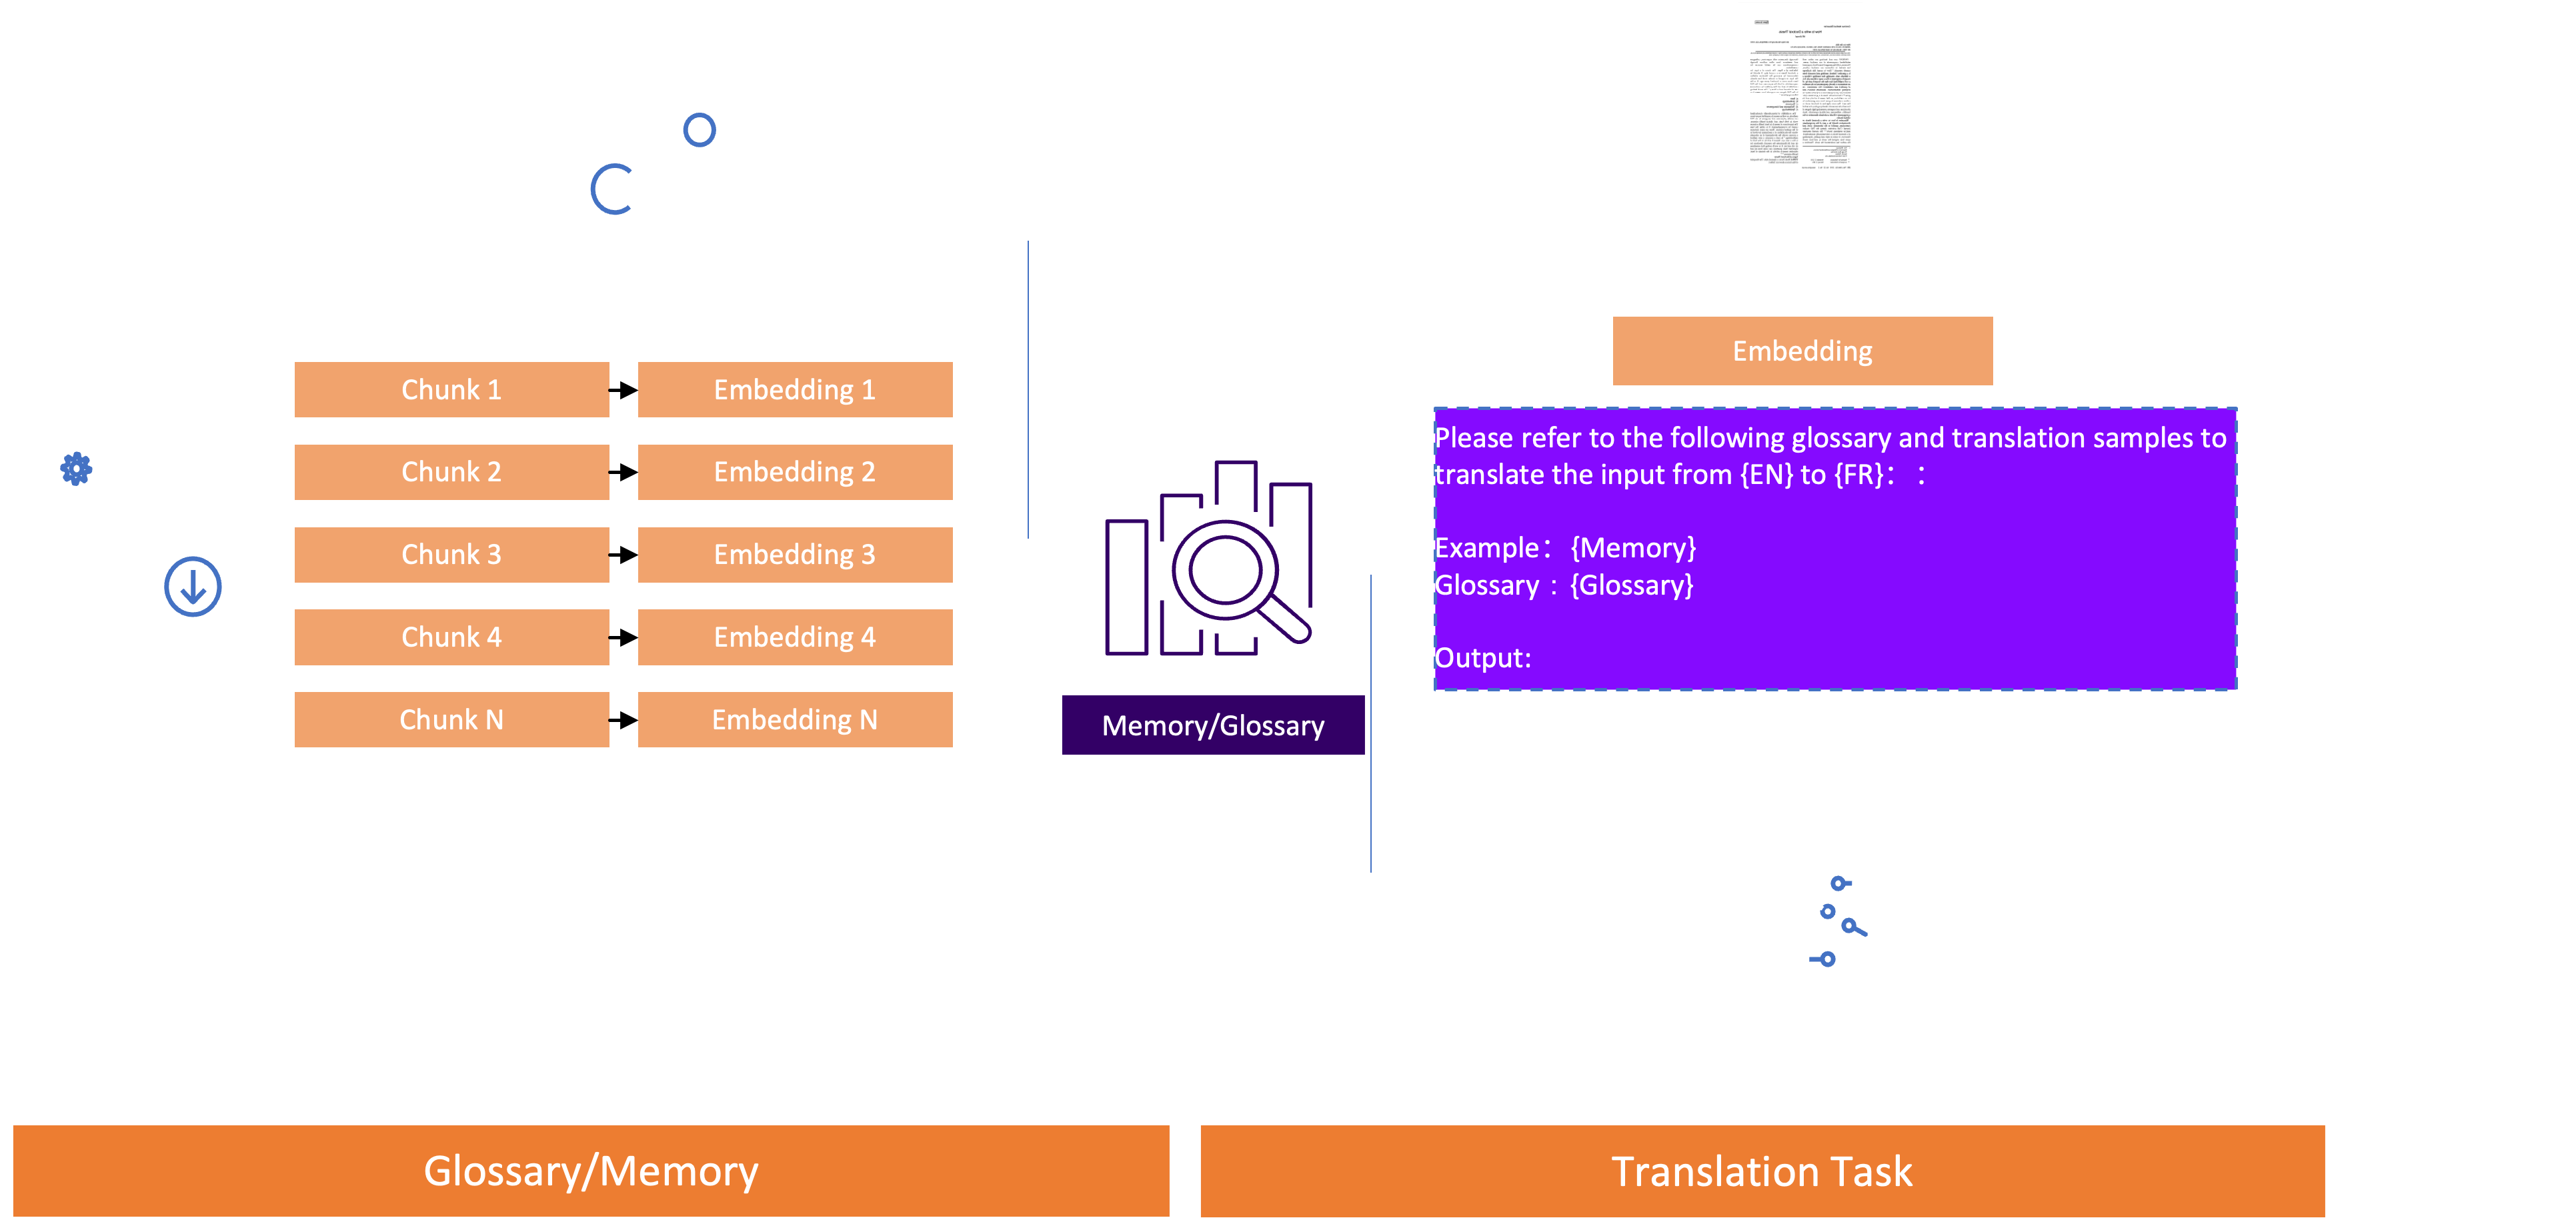
翻译工作流包含离线和在线两个阶段:离线处理术语数据库和参考文档,在线检索基于相似度为大语言模型翻译提供上下文
系统架构
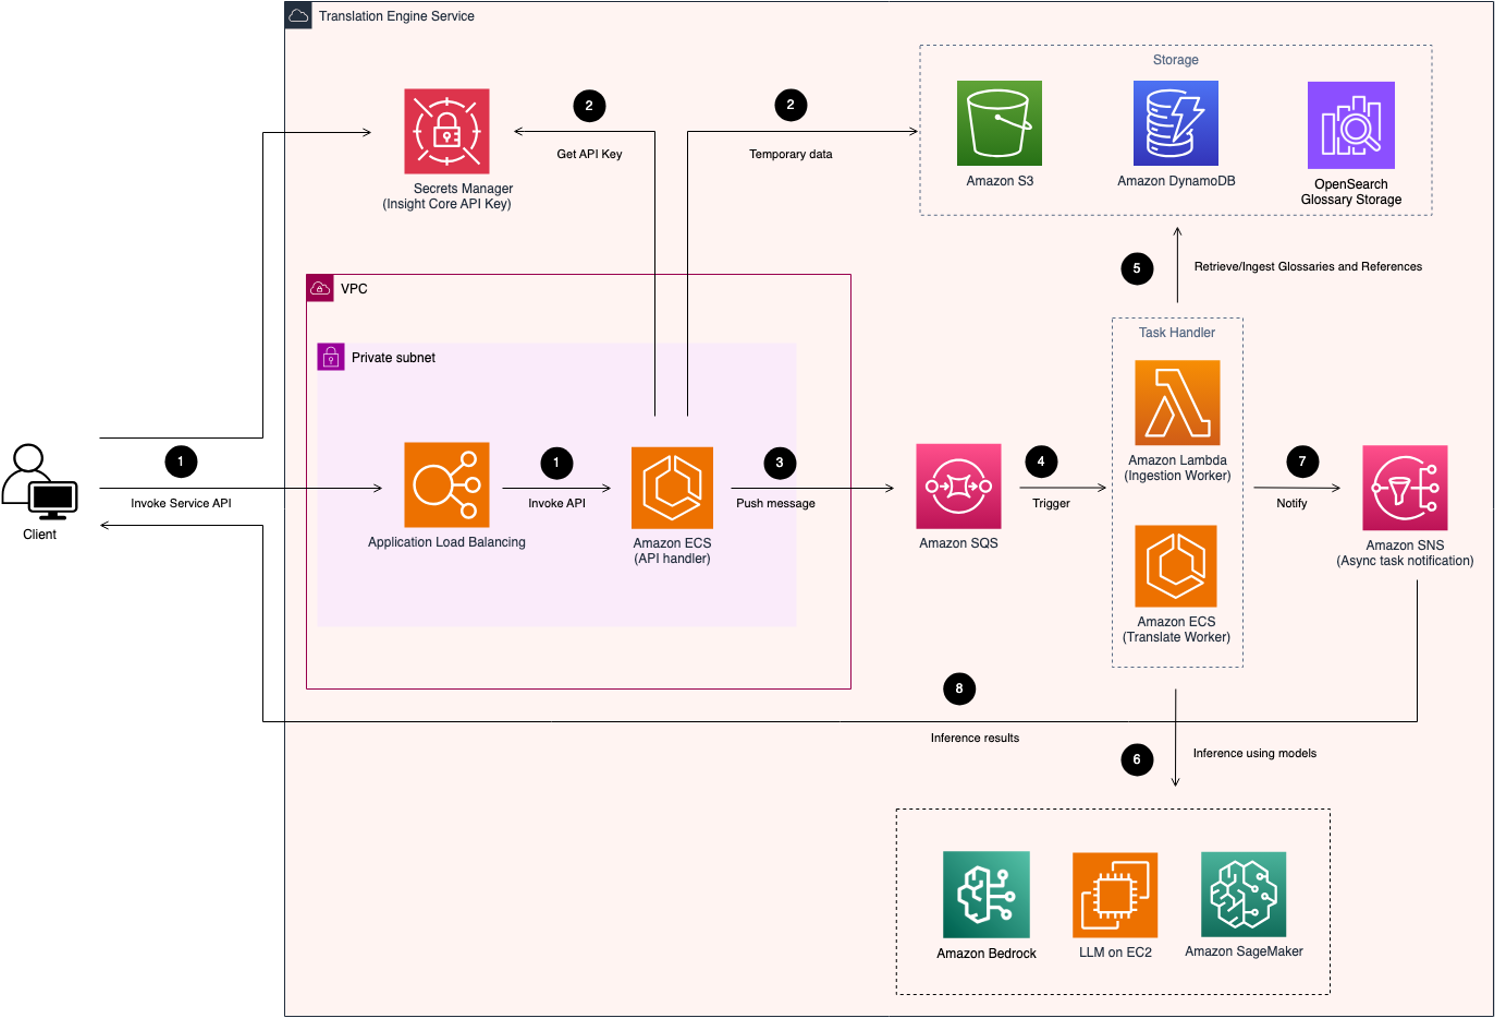
完整系统架构,展示端到端翻译流水线与AWS服务集成及可扩展处理组件
核心成就
AWS Summit China 2025 特邀演讲
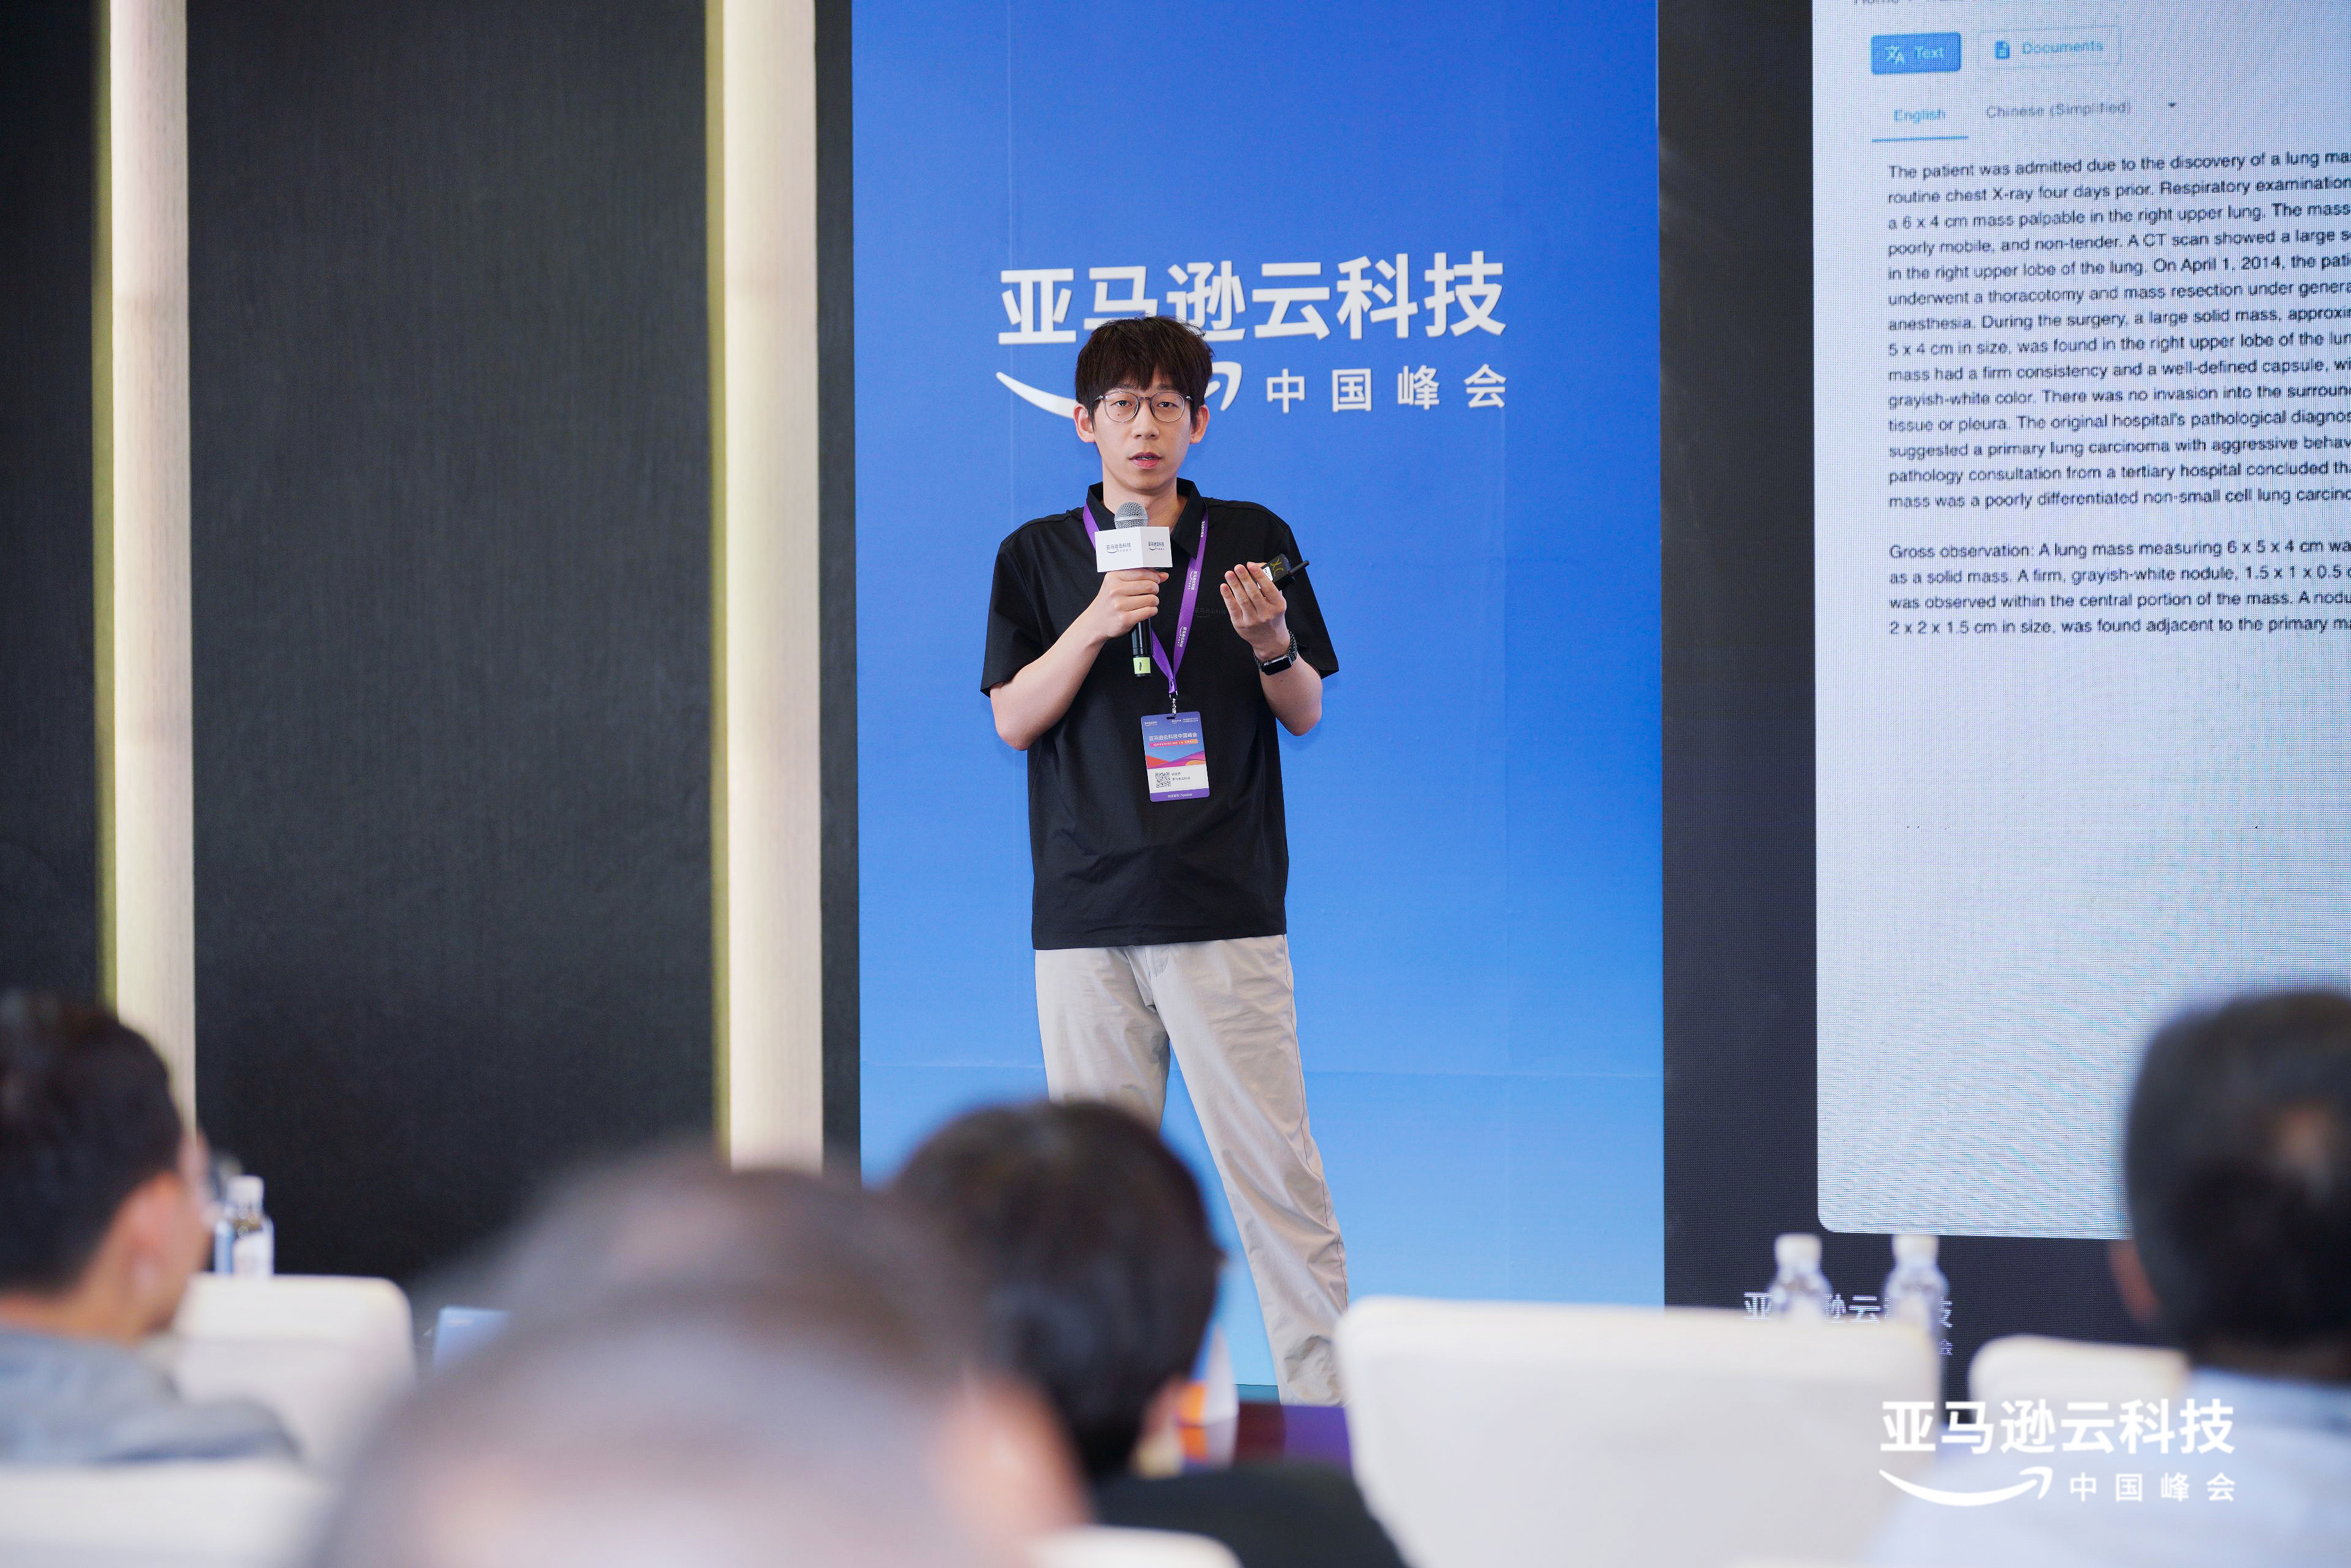
百万术语与信达雅——文档智能翻译背后的秘密
AWS Summit China 2025 · 亚马逊云科技中国峰会特邀演讲嘉宾,现场200+人
技术栈
AI/ML与大语言模型基础设施
搜索与数据
编程语言
后端与API
前端开发
文档处理
基础设施与部署
展示内容均基于公开信息或脱敏数据处理。